
使用
模块信息
介绍文档
| 编号 | 627 | |
| 名称 | Signal Peptide Prediction (TSignal) | |
| 封面 |  | |
| 描述 | 根据蛋白质 FASTA 序列预测信号肽类型和切割位置。 | |
| 标签 |
| |
| 作者 | Alexandru Dumitrescu | |
| 发布时间 | 2026-11-04 19:13:58 | |
| 参考文献 | Alexandru Dumitrescu, Emmi Jokinen, Anja Paatero, Juho Kellosalo, Ville O Paavilainen, Harri Lähdesmäki (2023) TSignal: a transformer model for signal peptide prediction, Bioinformatics, 39:Suppl 1 | |
目录导航
- 简介
- 参数说明
- Protein Sequences
- Output
- 结果说明
- 参考文献
Signal Peptide Prediction (TSignal)
简介
TSignal 使用 ProtBERT 和 Transformer 预测蛋白质序列的信号肽类型及切割位置。该工具由 Dumitrescu 等人提出;预测可帮助筛选候选序列,但不能代替实验验证。本模块分析每条序列的前 70 个氨基酸。
参数说明
Protein Sequences
上传 FASTA 格式的蛋白质序列文件,可包含多条记录。每条以 > 开头的标识行及后续氨基酸序列组成,例如:
>protein_1
MALWMRLLPLLALLALWGPDPAAA
>protein_2
MVHLTPEEKSAVTALWGKV
protein_1 和 protein_2 是序列标识,其后各行为对应氨基酸序列。
模型只分析每条序列的前 70 个残基。这部分只接受 20 种标准氨基酸和 X(未知残基),大小写均可;第 70 位之后的字符不参与预测也不检查,序列末尾的 * 会被自动去除。含其他字符(如 U、B、Z、O、J)的记录和空序列不进入预测,原因写入 errors.csv,其余记录继续;全部记录都无效时作业失败。每次最多处理前 10000 条记录,超出部分跳过。
Output
预测结果文件名,默认 predictions.csv。
结果说明
| 输出文件 | 说明 |
|---|---|
| predictions.csv | 每条成功预测的序列一行,给出逐残基标签、信号肽类型、切割位置和位置分数。 |
| saliency.json | 原始显著性信息,包含计算状态;不可用时保留原因。 |
| saliency.csv | 可计算显著性的残基各占一行,给出类型和切割位置的重要性。 |
| errors.csv | 未能预测的记录及原因。没有失败记录时只有表头。 |
预测只用每条序列的前 70 个残基。切割位置是预测结果。显著性表只包含首标签为 S、T 或 L 且能确定切割位点的序列,其余序列不出现在该表中,原因写在 saliency.json。这些分数不是校准概率,也不能代替实验确认。
predictions.csv 包含以下信息:
| 字段 | 说明 |
|---|---|
| Sequence_Id | FASTA 标识,取标题里第一个空白之前的文本。同一标识重复出现时各占一行。 |
| Sequence | 去掉末尾 * 后的完整氨基酸序列。预测只用前 70 个残基,此列仍保留全长。 |
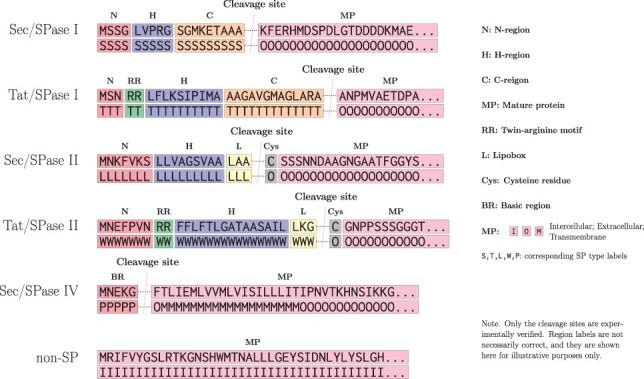
| Predicted_Labels | 被分析前缀的逐残基区域标签,一个字母对应一个残基,长度不超过 70。S 为 Sec/SPI 信号肽,T 为 Tat/SPI,L 为脂蛋白信号肽(Sec/SPII),W 为 Tat 脂蛋白信号肽,P 为菌毛信号肽(Sec/SPIII),I 为胞内,M 为跨膜,O 为胞外或其他成熟区。 |
| Signal_Peptide_Type | 由第一个残基的标签决定:S 为 SP,T 为 TAT,L 为 LIPO,W 为 TATLIPO,P 为 PILIN,其余为 NO_SP。 |
| Cleavage_Site | 信号肽最后一个残基的位置,从 1 开始计数;切割发生在该位置与下一位之间。无信号肽,或分析范围内标签没有离开信号肽区时为空。 |
| Type_Score | 第一个残基上,模型给其预测标签的 Softmax 最大值,固定四位小数,介于 0 和 1。数值越大,模型对该位置标签越有把握。这是未校准的位置分数,不是整条序列的类型概率。 |
| Cleavage_Score | 信号肽区之后第一个残基上,模型给其预测标签的 Softmax 最大值,固定四位小数。没有切割位点时为空。同样不是校准概率。 |
| Description | 完整 FASTA 标题,不含开头的 >。 |
saliency.csv 包含以下信息:
| 字段 | 说明 |
|---|---|
| Sequence_Id | 与预测表相同的序列标识。 |
| Token_Position | 被分析残基的位置,从 1 开始,最大为 70。每个预测残基一行,不含特殊 token。 |
| Type_Importance | 该残基对信号肽类型预测的梯度绝对值之和,四位小数。数值越大,该残基对类型判断的影响越大。不是概率,没有 0 到 1 的固定上限。 |
| Cleavage_Importance | 该残基对切割位点预测的梯度绝对值之和,四位小数。数值越大,该残基对切割位置判断的影响越大。不是概率。 |
errors.csv 包含以下信息:
| 字段 | 说明 |
|---|---|
| Sequence_Id | 未能预测的 FASTA 标识。 |
| Reason | 失败原因。空标识为 empty identifier,空序列为 empty sequence,前 70 位含不支持的字符时为 unsupported residues in the first 70 positions: 并列出那些字符。 |
参考文献
- Alexandru Dumitrescu, Emmi Jokinen, Anja Paatero, Juho Kellosalo, Ville O Paavilainen, Harri Lähdesmäki (2023) TSignal: a transformer model for signal peptide prediction, Bioinformatics, 39:Suppl 1, DOI: 10.1093/bioinformatics/btad228

