
| 编号 | 626 | |
| 名称 | Structure Prediction (Mol-1) | |
| 封面 |  | |
| 描述 | Mol-1 是由 Molence Bio 基于 Protenix 开发的生物分子结构预测模型,用于预测生物分子及其复合物的三维结构并评估预测置信度。 | |
| 标签 |
| |
| 作者 | Molence Bio | |
| 发布时间 | 2026-10-30 00:00:00 | |
| 参考文献 | Molence Bio (2026) Mol-1: Open Frontier Biomolecular Intelligence | |
- 简介
- 参数说明
- Single
- Protein Sequence
- DNA Sequence
- RNA Sequence
- Ligand
- Ion
- Modification
- Covalent Bond
- Template Structure
- Template Chain Map
- Seeds
- Sample
- Input JSON
- Output Scores
- Batch
- 动态计算量
- Input JSON
- Protein Sequence
- DNA Sequence
- RNA Sequence
- Ligand
- Ion
- Modification
- Covalent Bond
- Template Structure
- Template Chain Map
- Seeds
- Cycle
- Diffusion Step
- Sample
- Data Type
- Protein MSA
- Template
- RNA MSA
- JSON Seeds
- Atom Confidence
- Device
- Output Archive
- Output Scores
- 结果说明
- Single
- Batch
- 打分表
- 参考文献
Structure Prediction (Mol-1)
简介
预测生物分子及其复合物的三维结构。Mol-1模型 由 Molence Bio 发布,从 Protenix 发展而来,沿用这一类结构预测的流程。先为蛋白质查找多序列比对(multiple sequence alignment,MSA),再用 Pairformer 整理序列单元两两之间的关系,然后用扩散采样生成坐标,最后为每个样本计算置信度。
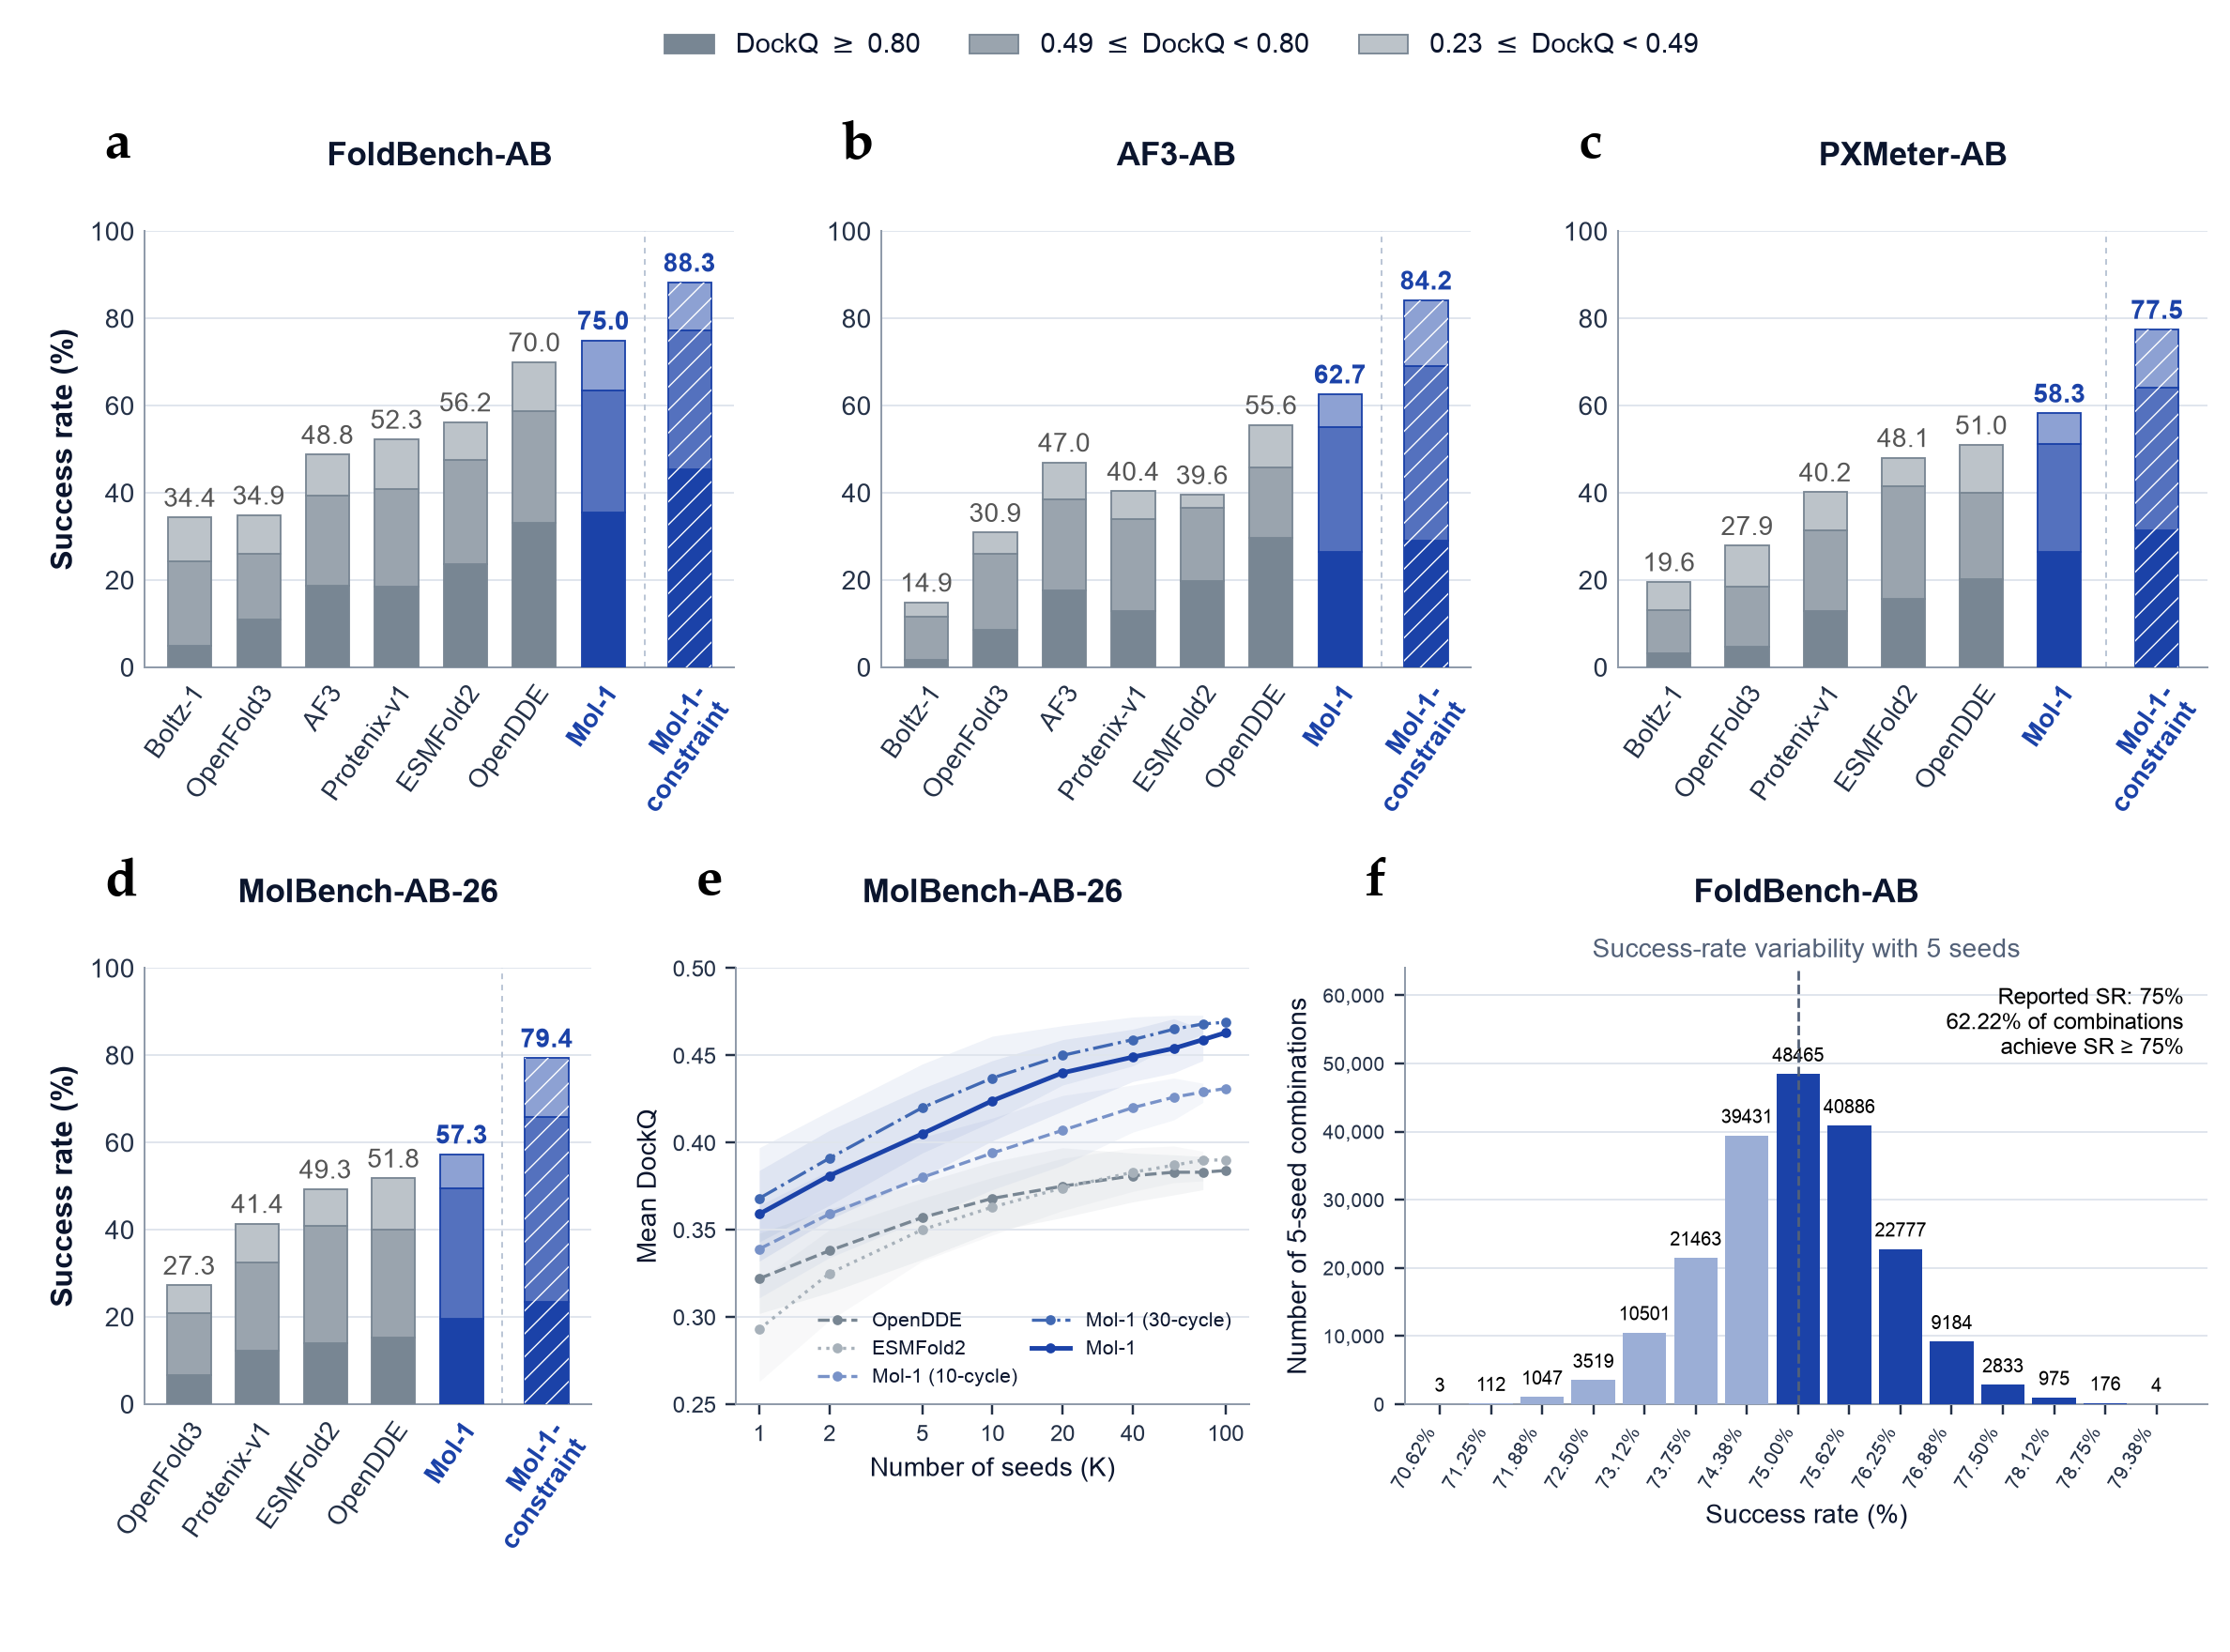
技术报告把 DockQ 大于 0.23 视为抗体–抗原成功。在五种子预算下,FoldBench-AB 上 Mol-1 为 75.0%,带约束的 Mol-1-constraint 为 88.3%,OpenDDE 为 70.0%。图中斜线柱是 Mol-1-constraint。本模块没有接触或口袋参数,不能复现那一档。图 (a)–(d) 使用五个种子;本模块默认只有种子 101。因此这些百分比不能直接当作本模块默认设置下的预期成功率。
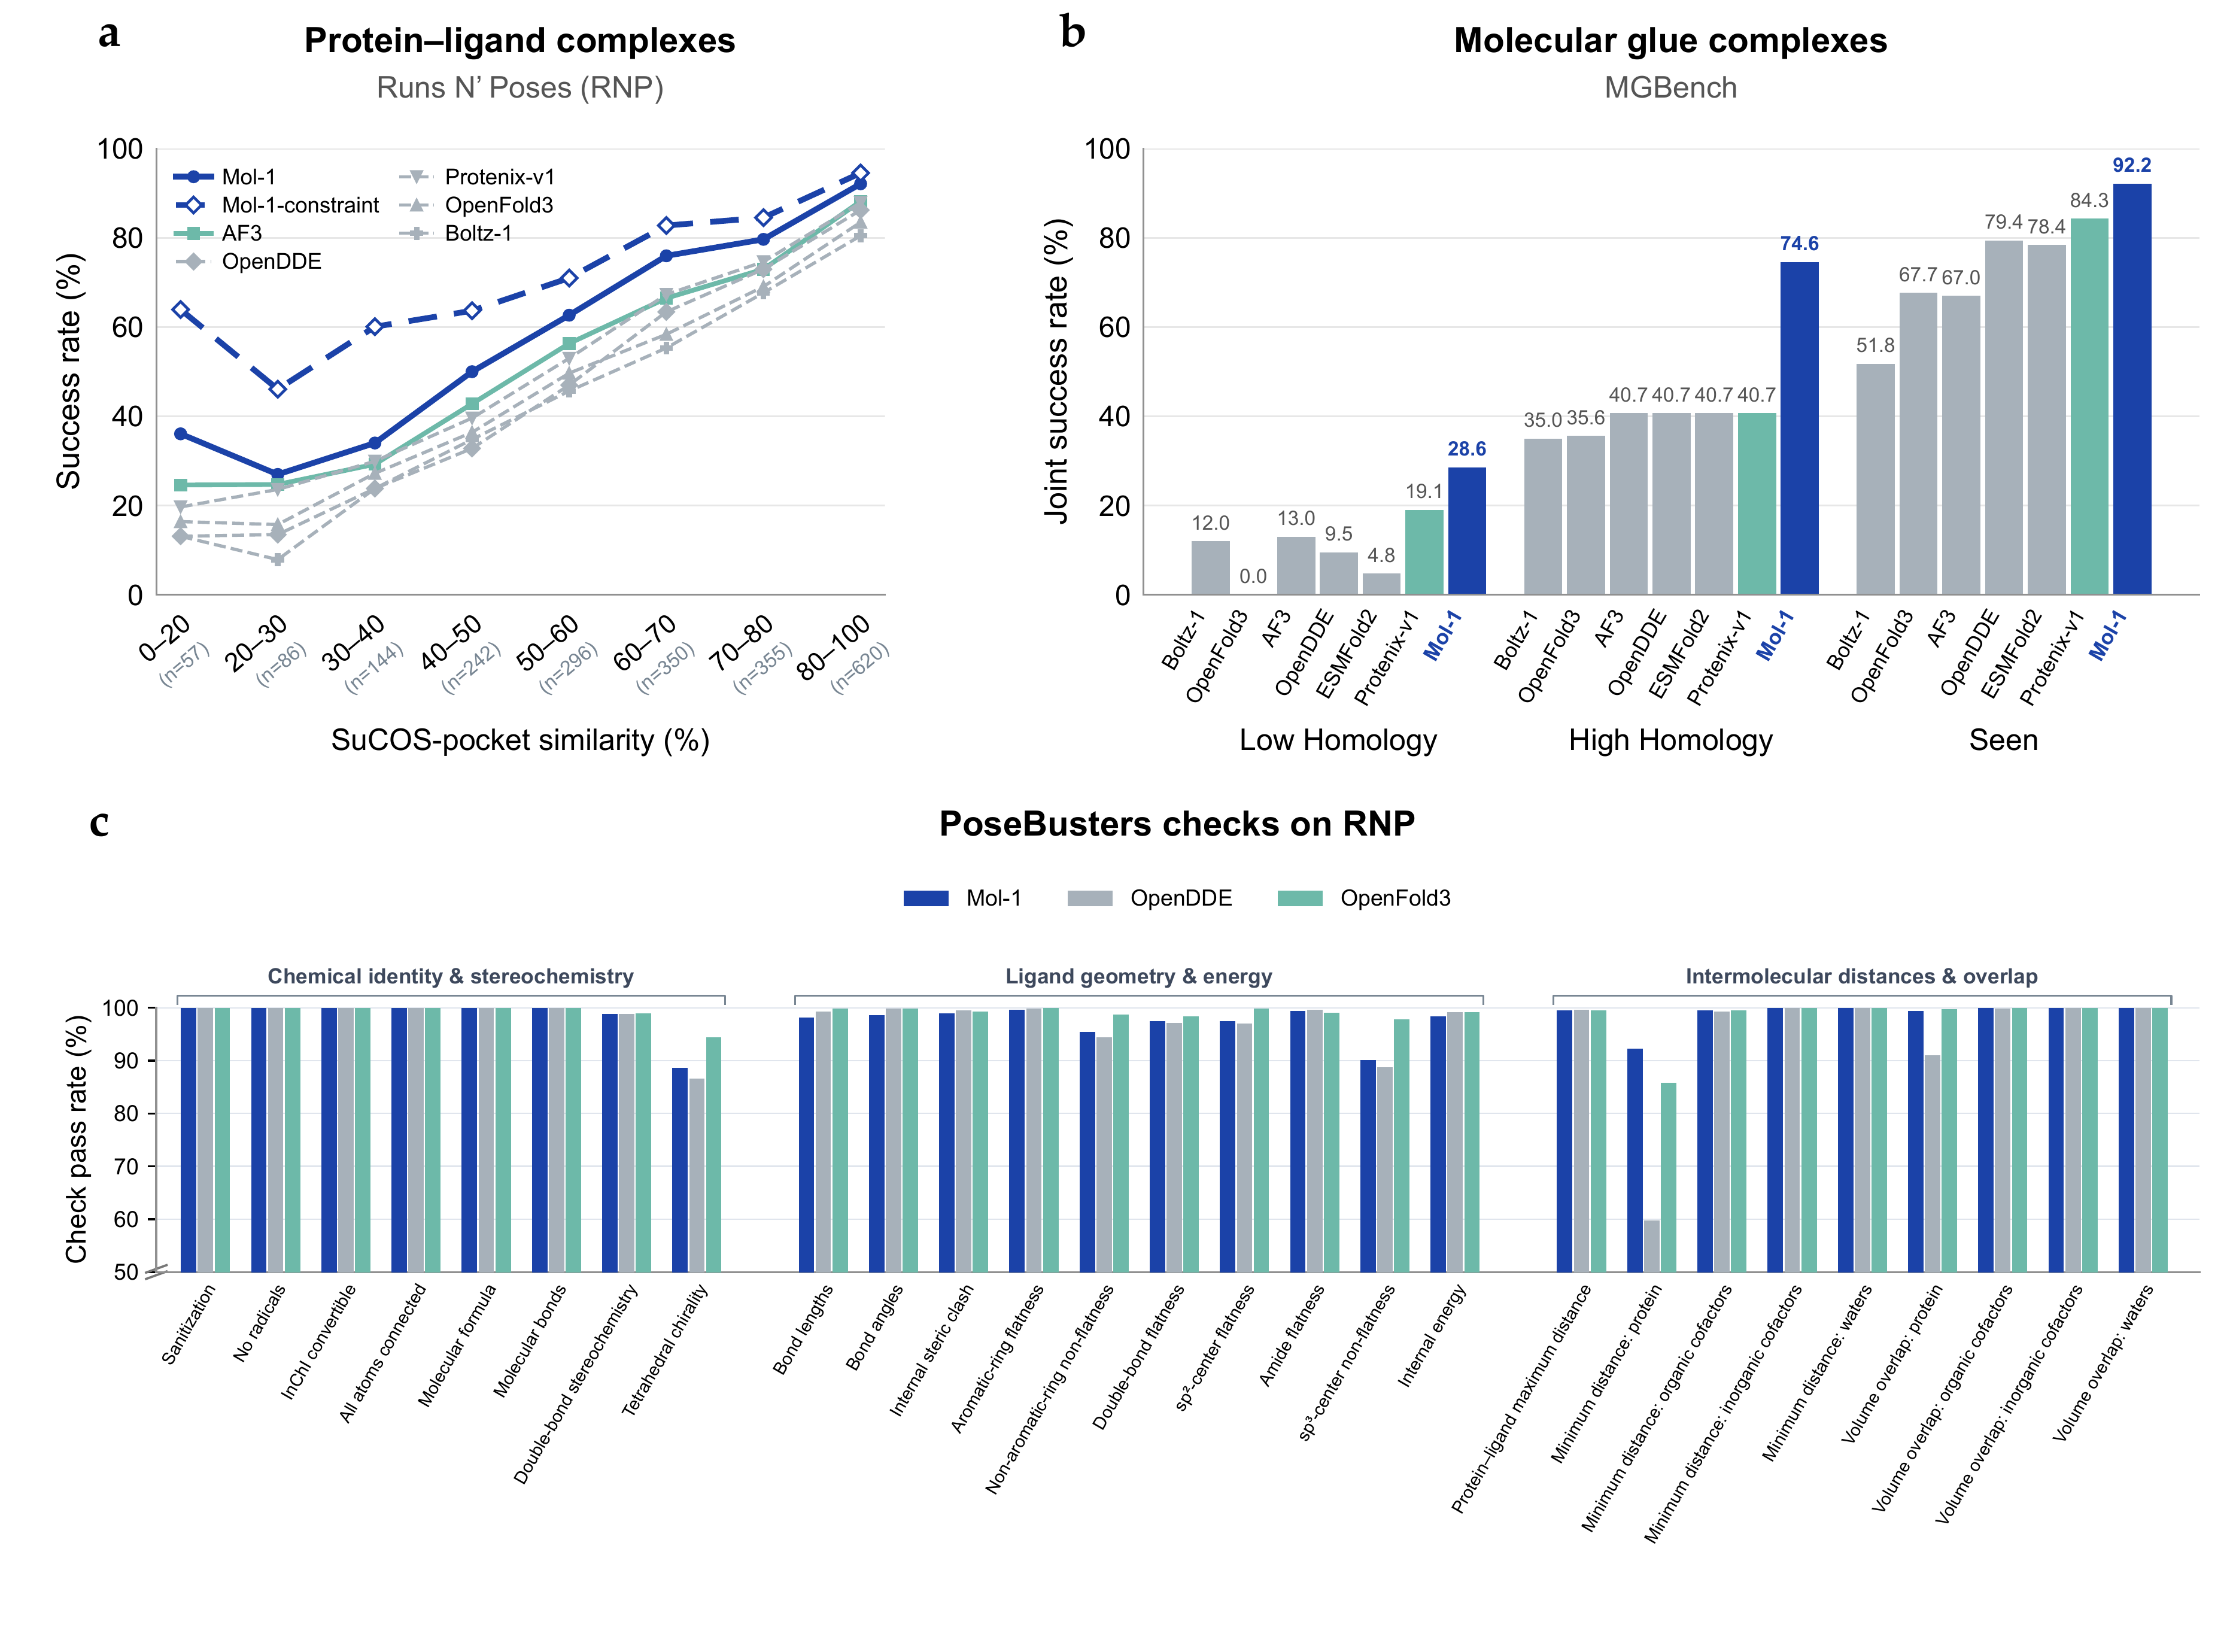
配体成功标准是配体 RMSD 小于 2 Å,并且 lDDT-PLI 大于 0.8。分子胶还要求蛋白–蛋白界面 DockQ 大于 0.23。报告列出的低相似口袋区间(SuCOS-pocket 相似度 0–20%)中,Mol-1 为 36.1%,Mol-1-constraint 为 63.9%。MGBench 低同源组的联合成功率为 28.6%。
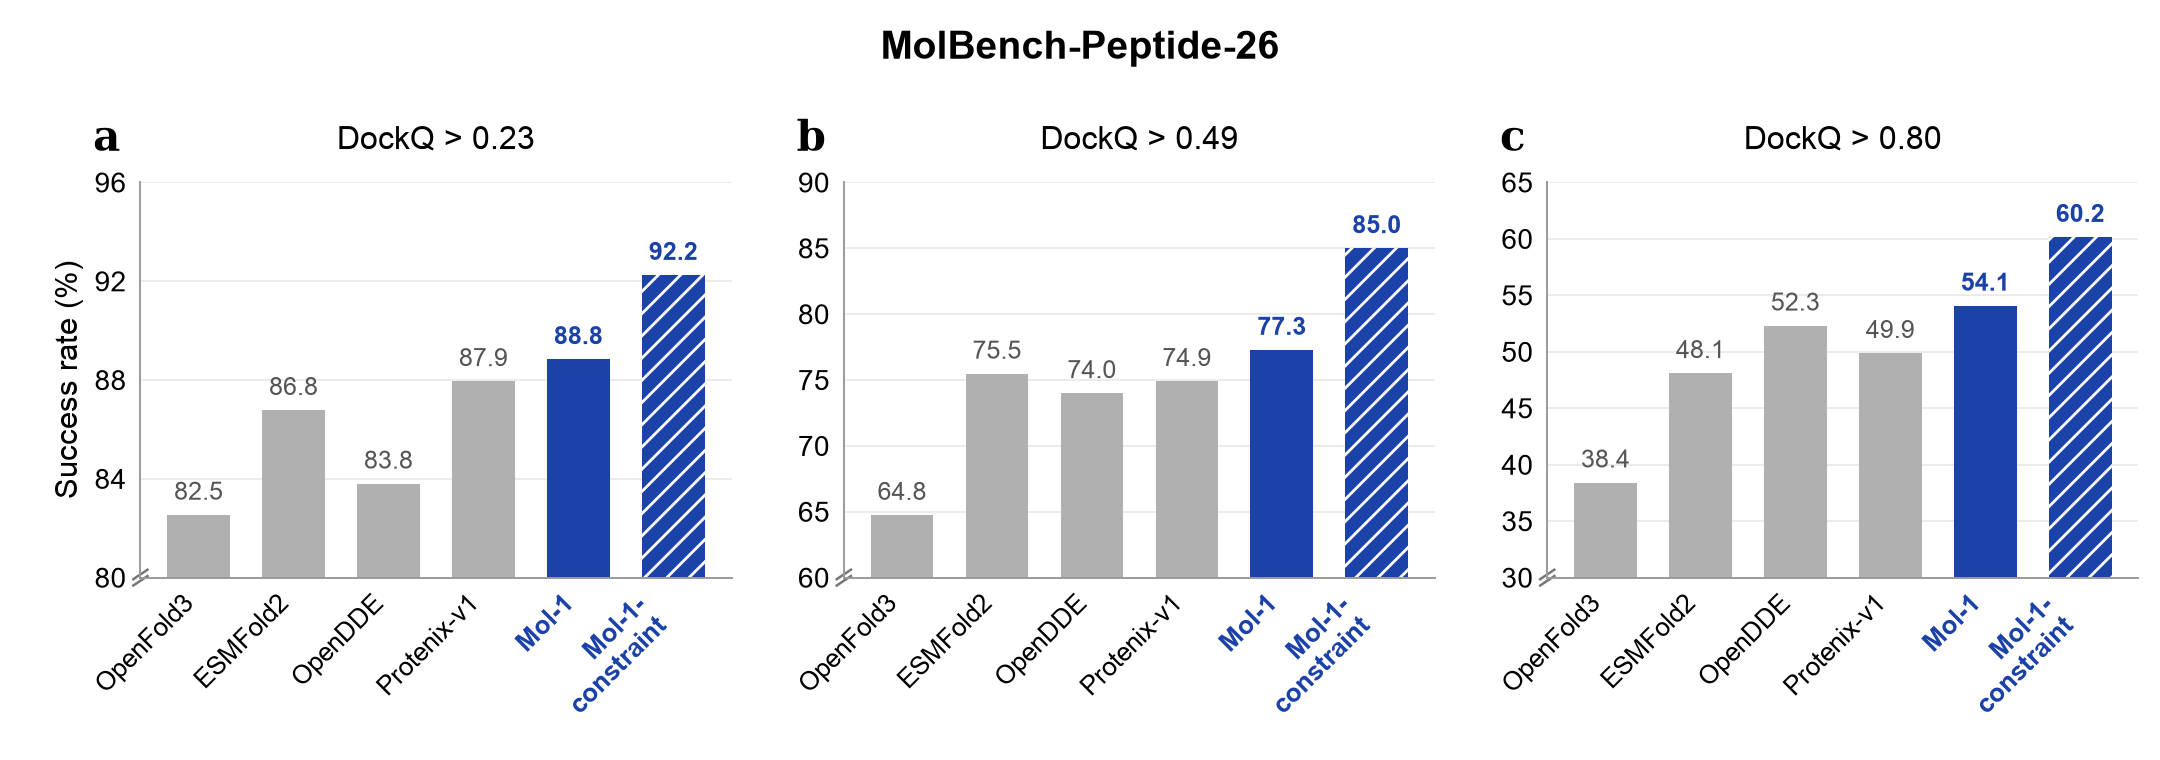
MolBench-Peptide-26 含 2026 年第一至第三季度的 150 个 PDB、172 个界面簇。报告中 Mol-1 使用 10 次循环。DockQ 大于 0.80 时 Mol-1 为 54.1%,Mol-1-constraint 为 60.2%。
本模块提供Single和Batch两种模式,Single预测一个体系,按排序分保留前 5 个结构。Batch 一次预测多个体系,并把全部样本放进一个压缩包。两种模式都可直接上传 Mol-1支持的JSON格式,也可以分别上传序列、配体、离子、修饰、共价键和模板结构文件。
参数说明
实体编号从 1 开始,顺序为蛋白、DNA、RNA、配体、离子。参数写法与 Structure Prediction (SoupFold) 类似。
Single
预测一个体系,按 ranking_score 从高到低保留前 5 个结构。
Protein Sequence
蛋白序列文件,FASTA格式,支持多条序列。
注意:多蛋白复合物结构预测,其氨基酸序列输入格式如下:
>protein1
AASJ...
>protein2
AASJ...
>peptide
ASDF...
DNA Sequence
DNA序列文件,FASTA格式,支持多条序列。
RNA Sequence
RNA序列文件,FASTA格式,支持多条序列。
Ligand
文本文件包含小分子信息,TXT格式。支持SMILES或 CCD Code(化学组分词典编号)。如果使用SMILES格式,每行应包含一个小分子;如果使用CCD Code,每行可以包含一个或多个小分子,使用逗号分隔,并加上CCD前缀。示例如下:
CC(=O)OC1C[NH+]2CCC1CC2
CCD,ATP,HY3,P1L
CCD,MG
也可以写 FILE_ 加同一作业中的结构文件名,支持 PDB、SDF、MOL 或 MOL2,并使用文件中的三维坐标,例如 FILE_ligand.sdf。
注意:不适用于配体蛋白或多肽的氨基酸序列格式输入。
Ion
离子名称,可以包含一个或多个离子,需写在一行文本中,不同的离子使用英文逗号分隔,支持输入离子数量,使用英文冒号分隔。示例如下:
MG:2,ZN,CU:3
表示2个MG离子,1个ZN离子,3个CU离子
Modification
包含翻译后修饰(PTM)信息的文本文件,TXT格式。每行放置一个PTM信息,每个PTM信息由三部分组成:
- 发生PTM序列的顺序编号
- PTM类型的CCD编号
- 发生PTM的残基位置编号
三部分由逗号分隔,例如:1,HY3,1表示第一条序列的第一个残基,发生了类型为HY3(CCD编号,为3-羟基脯氨酸,为脯氨酸的羟基化)的PTM
备注: - 序列的顺序编号,是依次按上述参数Protein、DNA、RNA中的序列顺序与数量,从1开始进行编号,例如:当有2条蛋白序列,1条DNA序列,1条RNA序列时,各序列对应的编号为:第一条蛋白序列编号为1,第二条蛋白序列编号为2,DNA序列编号为3,RNA序列编号为4
- CCD的介绍参考https://www.wwpdb.org/data/ccd 编号查询网址为https://www.ebi.ac.uk/pdbe-srv/pdbechem/
包含多个PTM信息的文件内容示例如下:
1,HY3,1
1,P1L,5
2,HY3,3
Covalent Bond
共价键信息的文本文件,TXT格式。每行放置一个共价键信息,每个共价键信息包含两个原子信息,每个原子信息由三部分组成:
- 原子所在序列或小分子的顺序编号(编号规则在Modification中定义的序列编号规则基础上,在最后加入小分子的顺序即可)
示例一:
当有2条蛋白序列,1条DNA序列,1条RNA序列,2个小分子时。对应的编号为:
第一条蛋白序列编号为1,第二条蛋白序列编号为2,DNA序列编号为3,RNA序列编号为4,第一个小分子对应的编号为5,第二个小分子对应的编号为6
示例二:
当有3条蛋白序列,2个小分子时。对应的编号为:
第一条蛋白序列编号为1,第二条蛋白序列编号为2,第三条蛋白序列编号为3,第一个小分子对应的编号为4,第二个小分子对应的编号为5
- 原子所在残基的位置编号(如残基为小分子时,编号为1)
- 原子的标准名称:
- 默认是CCD中定义的原子标准名称
- 如果配体是SMILES,则是SMILES字符串中原子对应的从1开始位置序号。
三部分由逗号分隔,
- 当小分子为CCD时,如
3,1,CA表示第三个实体(序列或小分子)中的第一个残基(或小分子)的CA原子
一个共价键是由两个原子信息组成,原子间用分号分隔,如:1,1,CA;2,1,CA
表示一个共价键,该共价键由两个原子组成,第一个原子为1,1,CA,第二个原子为2,1,CA
包含多个共价键信息的文件内容示例如下:
1,1,CA;2,1,CA
1,1,CA;3,1,CHA
- 当小分子为SMILES时,如
CC(=O)NCCNC(C)=O,如果该小分子的顺序编号(按上述方式确认)为3,其第一个C原子参与形成共价键,与编号为1的链/序列中第一个残基的CA原子,则共价键的定义为1,1,CA;3,1,C1其中C1表示小分子的第一个C原子,如果是第二个C原子,用C2表示。
文件内容示例如下:
1,1,CA;3,1,C1
两条聚合物残基之间的共价键通常不可靠;环肽的首尾酰胺,以及半胱氨酸之间的二硫键,是例外。其他聚合物之间的键即使写上,也往往只让相关残基靠近,而不形成真正的共价键。
Template Structure
上传一个 mmCIF 或 PDB 文件作为自定义模板,一个文件可以包含多条蛋白链。对上的查询蛋白链只用这份结构,不再混入自动搜索到的 PDB 模板。没有对上的蛋白链仍自动搜索 PDB。
Template Chain Map
指定查询蛋白链和模板链的对应关系,编号从 1 开始,只数蛋白链。例如 1:A,2:B 表示第 1 条查询蛋白链用模板的 A 链,第 2 条用 B 链。留空时用 kalign 按序列一致性自动配对,一致性低于 0.30 的查询链不使用该用户模板,改为自动 PDB 搜索。写明了对应关系但模板中没有该链或无法对齐时,作业失败。
Seeds
逗号分隔的整数随机种子,最多使用前 5 个。默认 101。
Sample
每个种子的样本数,正整数。这些样本按 ranking_score 放在同一次排序里,写出前 5 个。默认 5。
Input JSON
可选的 Mol-1 JSON,格式标记为 JSON,文件中只放一个体系。与下方文件同时给出时,文件覆盖同一种内容。不上传 JSON 时,提供蛋白、DNA、RNA、配体或离子文件之一。一条蛋白和一条 DNA 可以写成:
[
  {
    "name": "example",
    "sequences": [
      {"proteinChain": {"sequence": "MKTAY", "count": 1}},
      {"dnaSequence": {"sequence": "ATGC", "count": 1}}
    ]
  }
]
sequences 里还可以放 rnaSequence、ligand 和 ion。配体的值使用 CCD_ 前缀、SMILES,或 FILE_ 加结构文件名。
Output Scores
结果打分文件名。
Batch
一次预测多个体系。不上传 JSON 时,蛋白 FASTA 的每条记录定义一个体系;DNA 或 RNA 里没出现过的记录名会新建体系。与 JSON 同时给出时,记录名必须已经存在于 JSON,未知名称会报错,不会新建体系。没有写明所属体系的配体、离子、修饰和共价键行,会应用到每一个体系。
动态计算量
≤ 5 条序列:500 计算量 / 条
第 6–100 条序列:300 计算量 / 条
超过 100 条的部分:100 计算量 / 条
Input JSON
可选的 Mol-1 JSON,格式标记为 JSON。最外层是数组,每个元素是一个体系。不上传 JSON 时,用蛋白 FASTA 定义体系,每条记录一个体系。
Protein Sequence
蛋白的序列文件,FASTA格式,支持多条序列。
每一条记录代表一个待预测的结构,每条记录的名称要唯一不能重复。一条记录中有多条链时,通过英文冒号(:)相连,文件内容示例如下:
>1
EVQLVESGGGVVQPGRSLRLS:NFMLTQPHSVSVL:ELFPQWHLPIKIAAIIAS
>2
YYCAKDRRDMGYFQHWGQGTLVTVSSQWYQQRPGSAPTTVIYEDNQRPSGTPPTFMIAVFLPIVVLIFKSILFL
表示有两个待预测的结构,第一条记录的名称为1,有三条蛋白链,用:进行分隔。第二条记录的名称为2,为单链。
DNA Sequence
DNA核酸的序列文件,FASTA格式,支持多条序列。
每一条序列记录代表一个待预测的结构,每条记录的名称要唯一不能重复(可与Protein参数中的记录名称一致,表示该记录的DNA序列与Protein序列归属于同一结构)。一条记录中有多条链时,通过英文冒号(:)相连,文件内容示例如下:
>dna
GACCTCT:CCTAGCT
>1
CCTAGCT
表示有两条记录,第一条的名称为dna,有两条DNA链,用:进行分隔,因为该名称不存在与Protein示例记录中,属于新结构。第二条的名称为1,有一条DNA链,因为该名称存在于Protein示例记录中,则表示同属一个结构(该结构同时包含Protein序列和该DNA序列)。
RNA Sequence
RNA核酸分子的序列文件,FASTA格式,支持多条序列。
每一条序列记录代表一个待预测的结构,每条记录的名称要唯一不能重复(可与DNA或Protein参数中的记录名称一致,表示该记录的RNA序列与上面的DNA序列或Protein序列归属于同一结构)。一条记录中有多条链时,通过英文冒号(:)相连,文件内容示例如下:
>1
AGCU
>rna
AGGCU:UGAUC
表示有两条记录,第一条的名称为1,为单链,因为该名称存在于DNA及Protein示例记录中,表示同属一个结构(该结构同时包含了Protein序列、DNA序列及该RNA序列)。第二条的名称为rna,有两条RNA链,用:进行分隔,因为该名称不存在于DNA或Protein示例记录中,属于新结构。
Ligand
文本文件包含小分子信息,TXT格式。支持SMILES或 CCD Code(化学组分词典编号)。如果使用SMILES格式,每行应包含一个小分子;如果使用CCD Code,每行可以包含一个或多个小分子,使用逗号分隔,并加上CCD前缀。也可以写 FILE_ 加结构文件名。
以已有体系名开头时,名称与各个 ligand 用英文冒号(:)分隔,只加到该体系。不写体系名的一行会应用到每一个体系,不会因为出现新名称而新建体系。文件内容示例如下:
1:CC(=O)OC1C[NH+]2CCC1CC2:CCD,ATP,HY3
CC(=O)OC1C[NH+]2CCC1CC2:CCD,ATP
第一行只加到名为 1 的体系。第二行没有体系名,两个小分子会加到每一个体系。
注意:不适用于配体蛋白或多肽的氨基酸序列格式输入。
Ion
离子名称,可以包含一个或多个离子,需写在一行文本中,不同的离子使用英文逗号分隔,支持输入离子数量,使用英文冒号分隔。每行定义一个结构的所有离子信息,且以唯一名称开头,都以英文冒号(:)分隔。文件内容示例如下:
1:MG:2,ZN,CU:3
表示前述名称为1的结构中,有2个MG离子,1个ZN离子,3个CU离子
注意:在预测每个结构的序列数量相同的情况下,可为所有待预测结构设置相同的离子信息,设置方式为输入一行离子信息,且不设置结构名称,如:MG:2,ZN,CU:3,表示这些离子信息将应用到所有结构。
Modification
包含翻译后修饰(PTM)信息的文本文件,TXT格式。每个PTM的信息与Single模式中一致(参考Single模式中的定义)。
每行定义一个结构的所有PTM信息,且以唯一名称开头(该名称必须存在于前述的Protein或DNA或RNA记录中),都以英文冒号(:)分隔。文件内容示例如下:
1:1,HY3,1:1,P1L,5:2,HY3,3
2:1,HY3,1:2,HY3,3
表示前述名称为1的结构中(Protein或DNA或RNA),有三个PTM。名称为2的结构中,有两个PTM。
注意:在预测每个结构的序列数量相同的情况下,可为所有待预测结构设置相同的PTM信息,设置方式为输入一行PTM信息,且不设置结构名称,如:1,HY3,1:1,P1L,5:2,HY3,3表示这些PTM信息将应用到所有结构。
Covalent Bond
共价键信息的文本文件,TXT格式。每个共价键的信息与Single模式中一致(参考Single模式中的定义)。
Batch模式下,每行定义一个结构的所有共价键,且以唯一名称开头(该名称必须存在于前述的Protein或DNA或RNA记录中),都以英文冒号(:)分隔。文件内容示例如下:
1:1,1,CA;2,1,CA:1,1,CA;3,1,CHA
2:1,1,CA;3,1,CHA
表示前述名称为1的结构中(Protein或DNA或RNA),有两个共价键。名称为2的结构中,有一个共价键。
注意:在预测每个结构的序列数量相同的情况下,可为所有待预测结构设置相同的共价键信息,设置方式为输入一行共价键信息,且不设置结构名称,如:1,1,CA;3,1,CHA表示该共价键信息将应用到所有结构。
Template Structure
同 Single。批量提交时,同一份模板和链对应会用于每一个体系。
Template Chain Map
同 Single。
Seeds
同 Single。
Cycle
同 Single。
Diffusion Step
同 Single。
Sample
每个种子、每个体系的样本数,正整数。每个体系按 ranking_score 排序后保留前 5 个。默认 5。
Data Type
同 Single。
Protein MSA
同 Single。
Template
同 Single。
RNA MSA
同 Single。
JSON Seeds
同 Single。
Atom Confidence
高级参数。是否把原子级置信度放进压缩包。选择 true 或 false。默认 false。
Device
同 Single。
Output Archive
结果文件名,默认 structures.tar.gz。这里填文件名,不是目录。压缩包内是每个体系排序后的前 5 个结构,以及打分表。
Output Scores
结果文件名,默认 Mol-1_scores.csv。这里填文件名,不是目录。列含义与 Single 相同,见下方打分表。
结果说明
Single
| 输出文件名称 | 说明 |
|---|---|
| Mol-1_rank1.cif 至 Mol-1_rank5.cif | 按 ranking_score 从高到低的前 5 个结构。多个种子放在同一次排序里。不足 5 个时按实际数量写出。B-factor 列是每个原子的 pLDDT,范围 0–100。 |
| Mol-1_scores.csv | 上述结构的打分表,每个结构一行。 |
| full_data.json | 只在 Atom Confidence 打开时生成。包含按 token 编号的 PAE、PDE 和接触概率,不按 CIF 里的残基号。配体的一个重原子通常是一个 token。 |
Batch
| 输出文件名称 | 说明 |
|---|---|
| structures.tar.gz | 每个体系排序后的前 5 个 mmCIF,以及分数表。多个种子放在同一次排序里。 |
| Mol-1_scores.csv | 每个体系的排序结构各一行。 |
| Mol-1_体系名_rank1.cif | 只单独列出输入顺序中第一个体系的排序结构,最多 5 个。其余体系在压缩包中。 |
打开 Atom Confidence 后,每个样本的原子级置信度也放在压缩包里。这些文件名随体系和种子变化,不作为单独的固定输出。
打分表
Mol-1_scores.csv 的列如下。Single 与 Batch 使用同一套列。name 不带文件后缀:单体系为 Mol-1_rank1,多个体系为 Mol-1_体系名_rank1。
| 列名 | 说明 |
|---|---|
| name | 结构名称,不含 .cif。单体系为 Mol-1_rank1 至 Mol-1_rank5。多个体系为 Mol-1_ 加体系名再加 _rank1 至 _rank5,例如 Mol-1_pep_a_rank1。 |
| seed | 该样本使用的随机种子。 |
| sample | 同一种子内的样本编号,从 0 开始。 |
| ranking_score | 排序分,越高越靠前。计算公式为 0.8 × iptm + 0.2 × ptm − 100 × has_clash。多个种子放在同一次排序里。 |
| plddt | 全原子平均预测 lDDT,范围 0–100。大约 90 以上表示主链和侧链都比较有把握,70–90 表示主链比较有把握,50–70 把握较低,50 以下常对应无序区。 |
| ptm | 整体预测 TM-score,范围 0–1,越高越好。大于 0.5 时,整体折叠可能与真实结构相似。 |
| iptm | 界面预测 TM-score,范围 0–1,越高越好。单链体系为 0,这是没有界面,不是缺失值。大于 0.8 通常表示界面比较可靠,小于 0.6 时界面可能不可靠,0.6–0.8 介于两者之间。 |
| gpde | 整体预测距离误差,单位是埃,越低越好。 |
| has_clash | 不同聚合物链之间是否存在严重空间冲突。True 表示有冲突,排序分会减去 100。 |
| Avg_pAE | 接触概率加权的平均预测对齐误差,单位是埃,越低越好。它衡量残基对之间相对位置的预测可信度。大约低于 5 通常比较可靠,5–10 较为准确,10–20 不确定性较高,高于 20 往往不可靠。 |
| ipSAE | 界面 ipSAE,PAE 阈值为 10 Å,越高越好。单链留空。 |
| pDockQ2 | 聚合物链对中最高的 pDockQ2,用来看复合物界面。单链留空。可按 DockQ 的习惯理解:低于 0.23 通常不正确,0.23–0.49 可接受,0.49–0.80 为中等,高于 0.80 较高。 |
| pDockQ2_链名 | 该链相对其他链的 pDockQ2。列名带链标识,例如 pDockQ2_A、pDockQ2_B。有哪些链就写哪些列。 |
| pDockQ2_Avg | 各链 pDockQ2 的平均。没有链列时这一列也不出现。 |
参考文献
- Molence Bio (2026) Mol-1: Open Frontier Biomolecular Intelligence, technical report, GitHub: molence/Mol-1 assets/report.pdf

