
| 编号 | 566 | |
| 名称 | Protein Inverse Folding (Caliby) | |
| 封面 |  | |
| 描述 | 基于结构的蛋白质序列重设计(逆折叠)。Caliby 是基于 Potts 模型的结构条件序列设计方法,可针对单一骨架或结构构象集合进行序列采样;通过对多个可能构象进行联合约束,可降低对单一静态骨架的过拟合,并提升设计序列与目标结构的一致性。 | |
| 标签 |
| |
| 作者 | Richard W. Shuai | |
| 发布时间 | 2025-09-30 00:00:00 | |
| 参考文献 | Shuai, R.W., Lu, T., Bhatti, S., Kouba, P. & Huang, P.-S. Ensemble-conditioned protein sequence design with Caliby. bioRxiv (2025). | |
- 简介
- 参数说明
- Structure
- Chain
- Type
- Position
- Omit AAs
- Restrict AA Type
- Sampling Temp
- Number of Designs
- Seed
- 结果说明
- 参考文献
Protein Inverse Folding (Caliby)
简介
基于结构的蛋白质序列重设计(逆折叠)。基于 Caliby(Ensemble-conditioned protein sequence design)方法:以三维骨架为条件,用 Potts 模型在氨基酸序列空间采样,生成与目标结构相容、能量更优的设计序列。与仅依赖单一静态骨架的经典逆向折叠方法不同,Caliby 并不追求复现天然序列,而是通过对目标结构周围的多个变体进行建模(先用 Protpardelle-1c 对输入骨架做部分扩散,生成一组合成构象,再在系综约束下设计序列),增强结构一致性、自洽性与设计多样性,在benchmark中显著优于ProteinMPNN 和 ChromaDesign 等主流方法。特别是在 de novo 骨架和先前被 SolubleMPNN 判为“不可设计”的 binder 上,Caliby 展现出强大的适应性与拓展性,扩大了蛋白设计的可能空间。
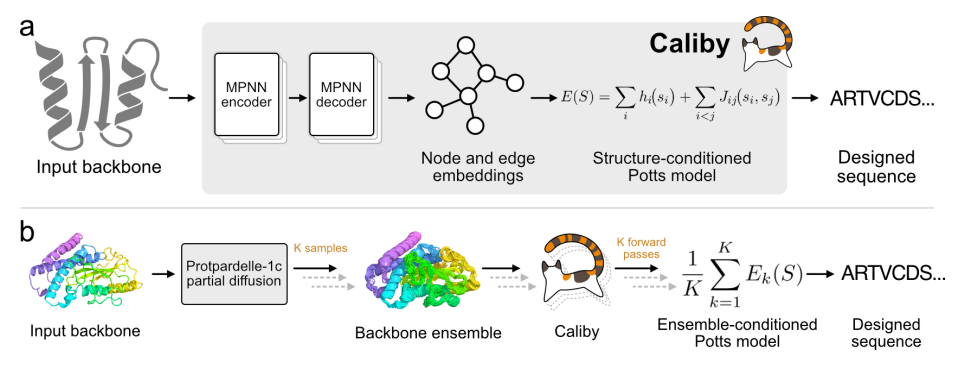
核心思路:在固定(或局部可动)主链几何下,学习位点偏好场 (h) 与位点成对耦合 (J),构成 Potts 能量 (U);采样时在该能量景观上搜索低能序列。评价与筛选以 Potts Energy((U)) 为主指标(数值越低通常越好),并辅以相对野生型的序列一致性。
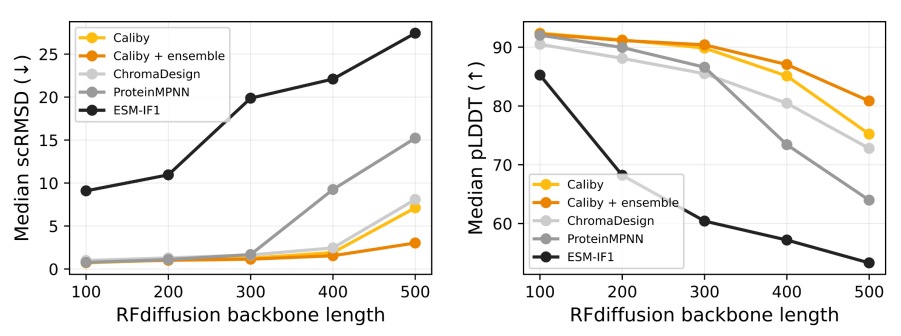
实验结果表明,集成条件的Caliby在天然骨架和全新骨架上的表现均优于最先进的模型ProteinMPNN和ChromaDesign。在85个长度在100到1000之间的天然骨架上,集成条件的Caliby实现了更好的自洽性。即使是那些先前设计性较差、ProteinMPNN和ChromaDesign无法成功设计的具有挑战性的天然骨架,集成条件的Caliby也能成功设计。
典型应用场景:
- 抗体 / 纳米抗体 CDR 或结合界面局部重设计。
- 固定催化位点、结合口袋关键残基(Fix),对其余骨架做重设计(Design)。
- 多链复合物界面共设计。
参数说明
Structure
蛋白结构文件,格式支持.pdb、.cif
Chain
指定进行 Design/Fix 的链 ID,逗号分隔,如 A 或 A,B。
Type
设计残基模式:固定(Fix,指定Position参数中的残基在设计时保持不变)或者设计(Design,指定Position参数中的残基进行设计,而其他未指定残基在设计时保持不变)。
Position
设置链上的残基序号,对设置的残基根据Type选项进行固定或设计。格式为链名+残基编号(从1开始的位置顺序编号),支持范围设置,多段区域时用逗号分隔,如:A85-100,A114,B1-100表示:
Chain参数指定的A链上,第85至100,114号残基,B链上,第1至100号残基,进行Type指定形式的固定或设计。
链名也可省略,如:85-100,114,表示Chain参数指定的所有链上的相同位置残基,进行固定或设计。
注意:Chain与Position参数必须至少设置一个。
Omit AAs
设计时全局排除的残基类型,逗号分隔单字母代码,如 C,M。用于避免二硫键半胱氨酸或甲硫氨酸氧化等问题残基。
Restrict AA Type
逐个位点残基类型限制文本文件,每行设置链名+残基编号(从1开始的位置顺序编号)及其类型限制,如:
A6-10:QR
A18:HS
20-30:QR
表示A链上的6-10号残基,设计时,限制残基类型为Q和R,不能变为其他类型残基;A链18号残基,限制类型为H与S。
支持省略链名,表示应用到Chain参数指定的所有链。
Sampling Temp
采样氨基酸概率分布时使用的“温度系数”,用来控制随机性/多样性。建议的取值为0.1、0.15、0.2、0.25、0.3。较高的值会导致更多的多样性。默认:0.1,数值范围为0 ~ 1.5。
Number of Designs
设计的序列数量,目前最大支持1000条。
Seed
随机种子,影响系综与采样可复现性。
结果说明
汇总文件 caliby_mutants.csv
按复合物全序列去重后的设计列表,按 Potts 能量排序,便于挑选独特序列:
Name,Duplicate_Count,Potts_Energy
A_Y34I_G56N_P58T_E74T_B_V29I_S31N_T57E_H91A,4,-1982.1284
A_Y34M_G56N_P58A_E74T_B_V29I_S31N_T57E_H91A,6,-1981.9233
| 列名 | 含义 |
|---|---|
| Name | 相对野生型的突变命名(链前缀 + 野生型氨基酸+位点+突变氨基酸);无突变则为 A_WT 等形式 |
| Duplicate_Count | 该唯一序列在全部采样中出现的次数 |
| Potts_Energy | Potts 能量值,是神经网络推导的 Potts 模型对给定氨基酸序列与输入骨架结构之间兼容性的定量评分。它不是一个物理自由能,而是一个统计能量(statistical energy),越低表示该序列越"适合"目标结构。 |
序列文件 caliby_designed.fasta
含野生型与去重后的设计序列。标题示例:
>A_WT_B_WT
...
>A_Y34I_G56N_..._B_V29I_...; overall_identity=0.965; nonfix_identity=0.758; potts_energy=-1982.1284; duplicate_count=4
...
| 属性 | 含义 |
|---|---|
| overall_identity | 设计链全部残基相对 WT 的氨基酸一致率 |
| nonfix_identity | 仅在 Design / 非固定位点上的一致率(通常明显低于 overall,因突变集中在可设计位点) |
| potts_energy | Potts 能量 (越低越好) |
| duplicate_count | 该序列重复出现次数 |
batch格式的复合物序列 caliby_complex_batch.fasta,完整复合物序列,多链以 : 连接,便于下游批量重折叠。
设计结构的打包压缩文件 caliby_designed.tar.gz
参考文献
- Shuai, R.W., Lu, T., Bhatti, S., Kouba, P. & Huang, P.-S. Ensemble-conditioned protein sequence design with Caliby. bioRxiv (2025). DOI:10.1101/2025.09.30.679633

