
| 编号 | 547 | |
| 名称 | AutoModel v2.0 | |
| 封面 | .png) | |
| 描述 | 基于蛋白语言模型(ESM-2、SaProt)和小分子语言模型(ChemBERTa、KPGT)的微调预测模块,支持分类和回归任务,可用于蛋白-小分子互作性质预测(如亲和力、催化效率)、蛋白性质预测以及小分子性质预测。模块提供特征融合、ML/MLP预测、Transformer全参数微调、LoRA参数高效微调及UniKP预测框架等多种建模方法。 | |
| 标签 |
| |
| 作者 | WECOMPUT | |
| 发布时间 | 2026-07-10 00:00:00 | |
| 参考文献 | ||
- 简介
- 1. 蛋白-分子互作性质预测
- 2. 蛋白性质预测
- 3. 小分子性质预测
- 参数说明
- Train
- Method
- Training Data
- Validation Data
- Test Data
- Task Type
- Protein Column
- Protein Structures
- Ligand Column
- Ligand Structures
- Label Column
- Regression Metric
- Classification Metric
- Epochs
- Use Log
- Use CV
- Seed
- Inference
- Input File
- Protein Column
- Protein Structures
- Ligand Column
- Ligand Structures
- Label Column
- Seed
- Model Status File
- Inference Mode
- Top N
- Target Value
- Target Class
- 结果说明
- 训练结果
- 回归任务的模型评价指标
- 分类任务的模型评价指标
- 推理结果
- 参考文献
AutoModel
简介
对蛋白语言模型(ESM-2 和 SaProt)和分子语言模型(ChemBERTa 和 KPGT)进行微调,支持分类(二分类)和回归任务。
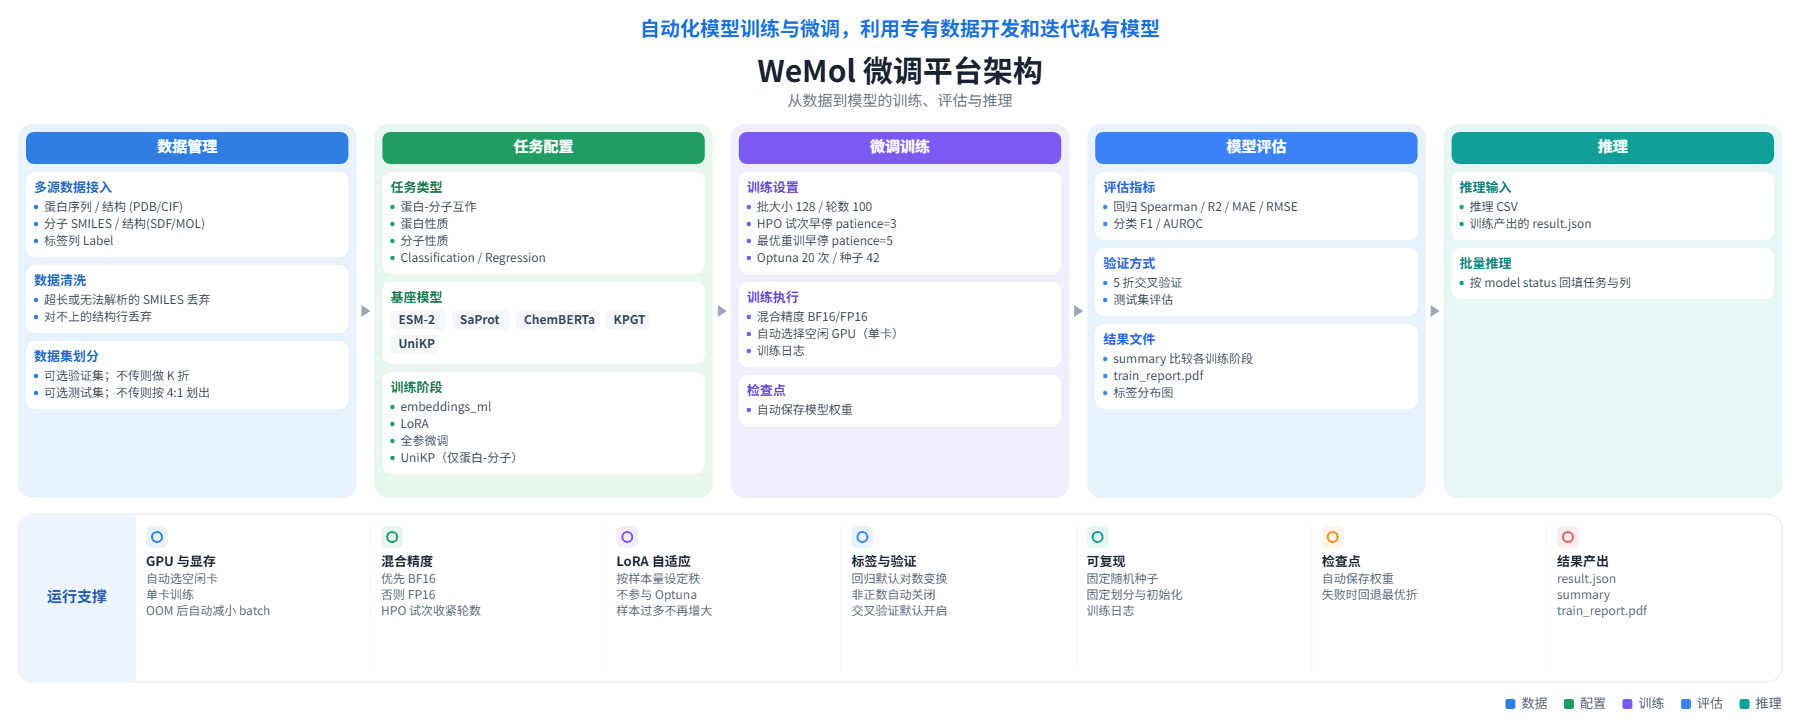
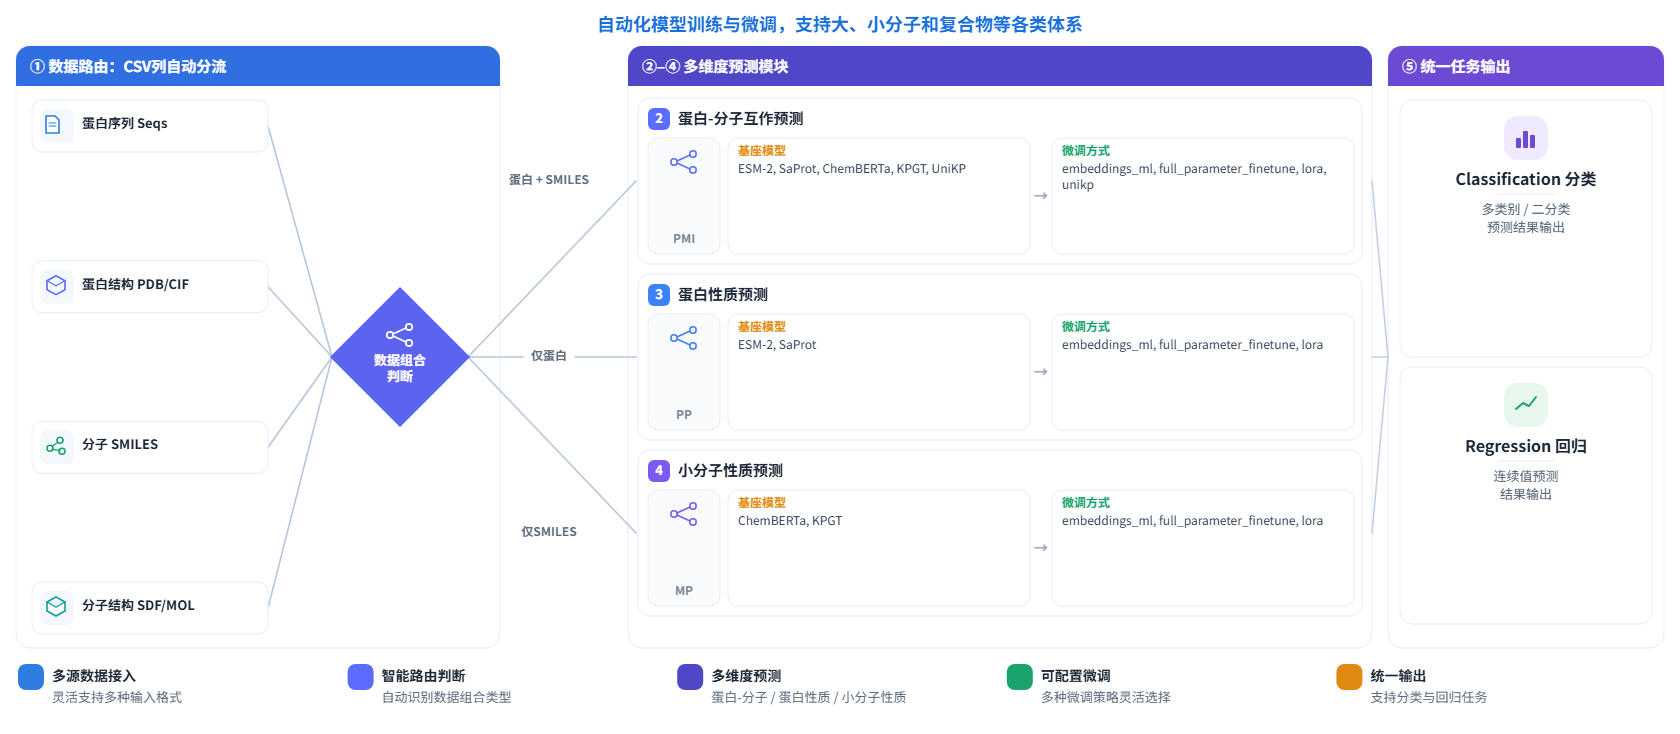
该模块提供了三种功能:
1. 蛋白-分子互作性质预测
例如酶-底物催化效率预测,蛋白质-分子亲和力预测等,有四种训练方法:
(1)蛋白序列特征与分子特征分别降维后,融合为优化的联合表征,之后联合特征 + 传统机器学习(ML)预测头 / 多层感知机(MLP)预测头进行预测
(2)基于 Hugging Face Transformer 的全参微调
(3)基于 Hugging Face Transformer 的 LoRA(Low-Rank Adaptation)参数高效微调
(4)UniKP 模型:用于预测酶动力学参数的统一框架,本框架中支持回归和分类预测
2. 蛋白性质预测
该模块提供了三种训练方法:
(1)蛋白特征 + 传统机器学习(ML)预测头 / 多层感知机(MLP)预测头
(2)基于 Hugging Face Transformer 的全参微调
(3)基于 Hugging Face Transformer 的 LoRA(Low-Rank Adaptation)参数高效微调
3. 小分子性质预测
该模块提供了三种训练方法:
(1)小分子特征 + 传统机器学习(ML)预测头 / 多层感知机(MLP)预测头
(2)基于 Hugging Face Transformer 的全参微调
(3)基于 Hugging Face Transformer 的 LoRA(Low-Rank Adaptation)参数高效微调
参数说明
Train
进行模型训练,可以训练:
- 蛋白-分子互作性质模型:需要蛋白序列或结构数据,以及分子SMILES或结构数据。
- 蛋白性质模型:需要蛋白序列或结构数据。
- 分子性质模型:需要分子SMILES或结构数据。
Method
训练方法,可选值(可多选):
embeddings_ml:序列特征 + ML/MLP预测头lora:基于 Hugging Face 的 LoRA 参数高效微调full_parameter_finetune:基于 Hugging Face 的全参数微调unikp:基于UniKP 模型预测进行预测
Training Data
用于模型训练的数据文件,格式为 CSV(逗号分隔的文本文件),文件中需包含用于训练的数据列(如:蛋白序列或蛋白结构名称、分子SMILES或分子结构名称)和标签列(活性、稳定性、酶催化活性等等),通过下述参数指定。
Validation Data
用于模型训练的验证数据文件,格式与Training Data相同。该参数默认为空:传入该文件时直接作为验证集使用;不传入时,则从训练集中划分得到验证集。
Test Data
用于模型训练的测试数据文件,格式与Training Data相同。该参数默认为空:传入该文件时直接作为测试集使用;不传入时,则从训练集中按 4:1 的比例划分得到测试集。
Task Type
任务类型,可选 Classification(分类)、Regression(回归)。
Protein Column
数据文件中蛋白数据的列名,可以是蛋白序列,或结构名称。
- 序列数据示例如下:
Seqs, Label
MQYKLILNGKTLKGETTTEAVDAATAEKVFKQYANDNGAAAEWTYDDATKTFTATELEVLFQGPLDPNSMATYEVLCEVARKLGTDDREVVLFLLNVFIPQPTLAQLIGALRALKEEGRLTFPLLAECLFRAGRRDLLRDLLHLDPRFLERHLAGTMSYFSPYQLTVLHVDGELCARDIRSLIFLSKDTIGSRSTPQTFLHWVYCMENLDLLGPTDVDALMSMLRSLSRVDLQRQVQTLMGLHLSGPSHSQHYRHTPLEHHHHHH,1.61
蛋白序列对应的列名为Seqs,所以该参数设置为Seqs
- 结构名称数据示例如下:
Structures,Label
3BJK,0
蛋白结构名称对应的列名为Structures,所以该参数设置为Structures
Protein Structures
当上述参数Protein Column对应的列值是结构名称时,上传实际的蛋白结构文件,每个结构文件支持PDB/CIF格式,支持批量结构文件,使用压缩打包文件格式(支持 .zip、.tar.gz、.tgz、.tar格式)。
Ligand Column
配体数据所在的列名;蛋白-分子互作或分子性质预测时填写。
- 序列数据示例如下:
SMILES,Seqs,Label
CCC(C)=O,MKLNFSGLRALVTGAGKGIGRDTVKALHASGAKVVAVTRTNSDLVSLAKECPGIEPVCVDLGDWDATEKALGGIGPVDLLVNNAALVIMQPFLEVTKEAFDRSFSVNLRSVFQVSQMVARDMINRGVPGSIVNVSSMVAHVTFPNLITYSSTKGAMTMLTKAMAMELGPHKIRVNSVNPTVVLTDMGKKVSADPEFARKLKERHPLRKFAEVEDVVNSILFLLSDRSASTSGGGILVDAGYLAS,-2.15
配体序列对应的列名为SMILES,所以该参数设置为SMILES
- 结构数据示例如下:
Seqs,SDF,Label
MKLNFSGLRALVTGAGKGIGRDTVKALHASGAKVVAVTRTNSDLVSLAKECPGIEPVCVDLGDWDATEKALGGIGPVDLLVNNAALVIMQPFLEVTKEAFDRSFSVNLRSVFQVSQMVARDMINRGVPGSIVNVSSMVAHVTFPNLITYSSTKGAMTMLTKAMAMELGPHKIRVNSVNPTVVLTDMGKKVSADPEFARKLKERHPLRKFAEVEDVVNSILFLLSDRSASTSGGGILVDAGYLAS,6569,-2.15
- 配体结构对应的列名为
SDF,所以该参数设置为SDF
Ligand Structures
数据文件中配体数据的列名。当Ligand Structures参数对应列中的值为配体结构名称时,需上传实际的分子配体结构文件。文件支持 SDF/MOL 格式,可使用压缩包格式(支持 .zip、.tar.gz、.tgz、.tar),也支持以包含全部对应分子结构的单一 SDF 文件作为输入。
Label Column
标签列名,默认Label,训练时用于监督学习。
Regression Metric
回归任务优化指标,可选 Spearman、R2、MAE、RMSE,默认 MAE。其中 Spearman 与 R² 越大越好,MAE 与 RMSE 越小越好。
Classification Metric
分类任务优化指标,可选 F1、AUROC,默认 F1,两者越大越好。
Epochs
训练轮数,主要用于 LoRA 和全参微调,默认 100。
Use Log
标签是否使用log转换,默认为True,当标签中存在不大于0的数值时,不进行标签转换。
Use CV
是否采用交叉验证,默认为True。
Seed
随机种子,用于确保实验可重复。
Inference
Input File
用于推理的数据文件路径,必传参数。用于模型推理的数据文件,格式为 CSV(逗号分隔的文本文件),文件中需包含用于推理的数据列(如:蛋白序列或蛋白结构名称、分子SMILES或分子结构名称),通过下述参数指定。
Protein Column
数据文件中蛋白数据的列名,可以是蛋白序列,或结构名称。
- 序列数据示例如下:
Seqs
MENGYTYEDYKNTAEWLLSHTKHRPQVAIICGSGLGGLTDKLTQAQIFDYGEIPNFPRSTVPGHAGRLVFGFLNGRACVMMQGRFHMYEGYPLWKVTFPVRVFHLLGVDTLVVTNAAGGLNPKFEVGDIMLIRDHINLPGFSGQNPLRGPNDERFGDRFPAMSDAYDRTMRQRALSTWKQMGEQRELQEGTYVMVAGPSFETVAECRVLQKLGADAVGMSTVPEVIVARHCGLRVFGFSLITNAVIMDYESLEKANHEEVLAAGKQAAQKLEQFVSILMASIPLPDKAS
蛋白序列对应的列名为Seqs,所以该参数设置为Seqs
- 结构名称数据示例如下:
Structures
3BJK
蛋白结构名称对应的列名为Structures,所以该参数设置为Structures
Protein Structures
当上述参数Protein Column对应的列值是结构名称时,上传实际的蛋白结构文件,每个结构文件支持PDB/CIF格式,支持批量结构文件,使用压缩打包文件格式(支持 .zip、.tar.gz、.tgz、.tar格式)。
Ligand Column
配体数据所在的列名;蛋白-分子互作或分子性质预测时填写。
- 序列数据示例如下:
SMILES,Seqs
CCC(C)=O,MKLNFSGLRALVTGAGKGIGRDTVKALHASGAKVVAVTRTNSDLVSLAKECPGIEPVCVDLGDWDATEKALGGIGPVDLLVNNAALVIMQPFLEVTKEAFDRSFSVNLRSVFQVSQMVARDMINRGVPGSIVNVSSMVAHVTFPNLITYSSTKGAMTMLTKAMAMELGPHKIRVNSVNPTVVLTDMGKKVSADPEFARKLKERHPLRKFAEVEDVVNSILFLLSDRSASTSGGGILVDAGYLAS
配体序列对应的列名为SMILES,所以该参数设置为SMILES
- 结构数据示例如下:
Seqs,SDF
MKLNFSGLRALVTGAGKGIGRDTVKALHASGAKVVAVTRTNSDLVSLAKECPGIEPVCVDLGDWDATEKALGGIGPVDLLVNNAALVIMQPFLEVTKEAFDRSFSVNLRSVFQVSQMVARDMINRGVPGSIVNVSSMVAHVTFPNLITYSSTKGAMTMLTKAMAMELGPHKIRVNSVNPTVVLTDMGKKVSADPEFARKLKERHPLRKFAEVEDVVNSILFLLSDRSASTSGGGILVDAGYLAS,6569
- 配体结构对应的列名为
SDF,所以该参数设置为SDF
Ligand Structures
数据文件中配体数据的列名。当Ligand Structures参数对应列中的值为配体结构名称时,需上传实际的分子配体结构文件。文件支持 SDF/MOL 格式,可使用压缩包格式(支持 .zip、.tar.gz、.tgz、.tar),也支持以包含全部对应分子结构的单一 SDF 文件作为输入。
Label Column
数据文件中记录性质标签的列名。存在时会计算评估指标,生成inference_metrics.json文件。
Seed
随机种子,用于确保实验可重复。
Model Status File
模型信息 JSON 文件路径,为训练阶段产出的 model status 文件,例如 result.json。
Inference Mode
推理结果的筛选方式,默认值为 Random。支持以下选项:
Largest:按预测值从高到低排序,优先保留预测值较高的样本。Smallest:按预测值从低到高排序,优先保留预测值较低的样本。Closest:按预测值与 Target Value 的差值绝对值从小到大排序,优先保留最接近目标值的样本。仅适用于回归任务。Random:随机选取样本。
Top N
筛选后保留的样本数量,可选参数。按 Inference Mode 指定的方式选取样本。
Target Value
回归任务的目标值。Inference Mode 设为 Closest 时必填,用于比较各样本的预测值与目标值的接近程度。
Target Class
分类任务中需要保留的目标类别,可选参数。指定后,仅保留预测类别与该值一致的样本。
结果说明
训练结果
result.json:模型信息文件,包含任务 ID、方法、模型路径等信息summary.csv:不同方法的性能比较结果
| 字段 | 说明 |
|---|---|
| Stage | 训练阶段(embeddings_ml / lora / full_parameter_finetune / unikp) |
| Task | 任务类型(Classification / Regression) |
| Metric_Name | 优化指标名称 |
| Metric_Value | 优化指标对应的值 |
| Model_Name | 机器学习名称 |
| Protein_Model | 蛋白质模型 |
| Molecule_Model | 分子模型 |
| ESM_Weight | ESM-2 权重 |
| SaProt_Weight | SaProt 模型权重 |
| ChemBERTa_Weight | ChemBERTa 权重 |
| Dimension_Reduction | 降维方式,支持 PCA、CNN、all、NONE,其中 NONE 表示不降维 |
| Merge_Method | 融合方式,支持 BAN、CONCATENATE、CROSS_ATTENTION、all |
- train_report.pdf:各方法的性能结果报告(PDF 格式)
回归任务的模型评价指标
| 指标 | 说明 |
|---|---|
| Spearman | 相关性指标,-1 至 1 之间,绝对值越大表示相关性越高,模型效果越好 |
| R2 | 决定系数,(-∞, 1],越大越好 |
| MAE | 平均绝对误差,数值越小越好。不同训练方法得到回归模型通过该参数进行排序,选取最优模型 |
| RMSE | 均方根误差,数值越小越好 |
| cv_Spearman | 交叉验证平均 Spearman |
| cv_R2 | 交叉验证平均 R² |
| val_Spearman | 验证集 Spearman |
| val_R2 | 验证集 R² |
分类任务的模型评价指标
| 指标 | 说明 |
|---|---|
| Accuracy | 准确率,整体预测正确的比例,0-1 之间,越大表示模型效果越好 |
| F1 | 精确率与召回率的调和平均值。不同训练方法得到分类模型通过该参数进行排序,选取最优模型 |
| AUROC | ROC 曲线下的面积,衡量模型区分正负类的能力,0-1 之间,越大表示模型效果越好 |
| cv_F1 | 交叉验证平均 F1 |
| val_F1 | 验证集 F1 |
推理结果
- inference.csv:原始数据集加上预测值
| 字段 | 说明 |
|---|---|
| Predictions | 预测值 |
| Predictions_Original | 映射到原始空间的预测值 |
-
inference_metrics.csv:推理阶段的模型评估指标文件。仅当
Input File中包含真实标签列时才会生成,记录模型在推理数据上的各项性能指标。- 分类:Accuracy、F1、AUROC、n_samples
- 回归:Spearman、RMSE、R2、n_samples、use_log
其中 n_samples 表示推理数据集的数量。
参考文献
- Yu, H., Deng, H., He, J. et al. UniKP: a unified framework for the prediction of enzyme kinetic parameters. Nat Commun 14, 8211 (2023).DOI: 10.1038/s41467-023-44113-1

