
| 编号 | 544 | |
| 名称 | Binder Design (Proteina-Complexa) | |
| 封面 |  | |
| 描述 | 设计与蛋白靶点或小分子相互作用的Binder蛋白。模块基于Proteina-Complexa模型框架实现,该框架采用“生成-过滤-评估-分析”的模块化流程,可在统一配置体系下切换不同目标类型与推理策略,并通过多类结构指标对设计结果进行打分与筛选。 | |
| 标签 |
| |
| 作者 | Kieran Didi | |
| 发布时间 | 2026-01-26 00:00:00 | |
| 参考文献 | Didi K, et al. Latent Generative Search Unlocks de novo Design of Untapped Biomolecular Interactions at Scale(2026).
Didi K, et al. Scaling Atomistic Protein Binder Design with Generative Pretraining and Test-Time Compute, ICLR 2026. | |
- 简介
- 参数说明
- Protein Binder
- Structure
- Chains
- Include
- Length
- Hotspot
- Number of Designs
- Ligand Binder
- Structure
- Ligand
- Length
- Number of Designs
- Motif & Ligand Binder(AME)
- Structure
- Contig Atoms
- Length
- Number of Designs
- Ligand
- 结果说明
- 参考文献
Binder Design (Proteina-Complexa)
简介
设计与蛋白靶点或小分子相互作用的Binder蛋白。模块基于Proteina-Complexa模型框架实现,该框架采用“生成-过滤-评估-分析”的模块化流程,可在统一配置体系下切换不同目标类型与推理策略,并通过多类结构指标对设计结果进行打分与筛选。
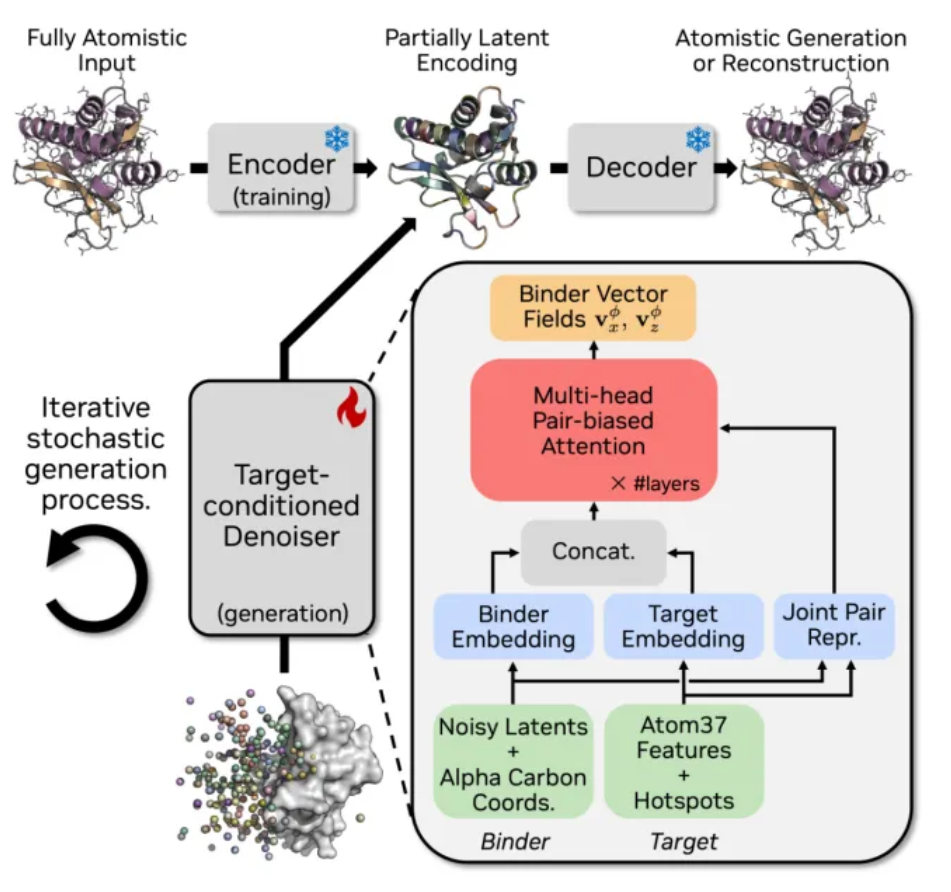
Proteina-Complexa的架构如下所示,在La-Proteina 的流匹配架构基础上,扩展为全原子生成,使用部分自编码器(Partial Autoencoder)用于潜空间表示。是首个在连续潜在空间中进行序列-结构联合生成+推理时搜索的蛋白质设计方法。
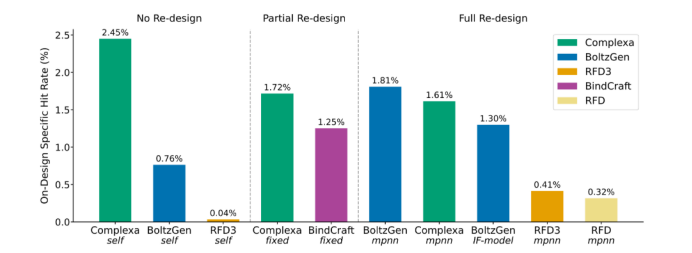
Proteina-Complexa团队联合多家生物公司、高校做了超大规模实验,生成了超100万种设计的结合剂。结果显示,其是目前从头设计蛋白质结合剂最强的开源模型。在127个不同类型的靶点里,成功设计出能和其中86个靶点结合的蛋白质,远超市面上主流蛋白质生成模型。与BoltzGen、RFDiffusion3、BindCraft等多个蛋白质生成模型进行比较,在75个靶点上评估了每个方法的序列重新设计组合的设计命中率及特异性。结果显示,Proteina-Complexa在所有靶点的平均命中率为2.45%。这个数字看起来不高,但第二名BoltzGen的成功率只有0.76%
当前支持三种设计模式:
- Protein Binder:指定靶点(支持多链),设计指定长度(范围)的Binder蛋白。
- Ligand Binder,指定小分子结构,设计指定长度(范围)的Binder蛋白。
- AME (Motif + Ligand Binder),指定已有蛋白残基(精确到原子)+小分子结构,设计指定长度(范围)的Binder蛋白 ,主要用于酶设计。
参数说明
Protein Binder
Structure
靶点结构文件,PDB或CIF格式。
Chains
指定从Structure中提取相应的链作为靶点,可多选,如:A,B。如不设置该参数,表示提取结构中的所有链作为靶点。
Include
从Chains参数指定的链中,进一步确认需要提取作为靶点的残基范围,使用链名+残基位置(从1开始的顺序编号,非PDB的UID编号)进行指定,如A10-20,A25,B1-36,B40。
表示:从A链提取编号10至20、25的残基,从B链提取编号1至36、40的残基,作为靶点。
如不设置该参数,表示提取Chains参数中指定的完整链。
Length
Binder蛋白的长度。支持:
- 确定长度:
100 - 长度范围:
60-120
Hotspot
设置靶点结构中的结合位点,格式使用链名+残基位置(同Include参数),如 A45,A67,A80-82表示A链中编号45,67,80至82的残基作为结合位点。
Number of Designs
设计的Binder数量,默认 100。
Ligand Binder
Structure
含有配体的结构文件,PDB或CIF格式。
Ligand
配体残基名,如:IAI
Length
Binder蛋白的长度。支持:
- 确定长度:
100 - 长度范围:
60-120
Number of Designs
设计的Binder数量,默认 100。
Motif & Ligand Binder(AME)
主要用于酶设计,例如:指定酶的催化位点残基作为Motif,底物作为ligand
Structure
含有Motif和ligand的结构文件,PDB或CIF格式。
Contig Atoms
指定结构中作为Motif的残基及其原子,注意必须精确到具体原子名称,文本文件,每行放置一个残基及其原子,格式使用链名+残基UID: 原子名称示例如下:
A64: O, C
A86: CB, CA, N, C
A90: CE1, ND1, NE2, CG, CD2
A114: N, CA
A137: NE1, CD1, CE2, CG, CD2, CZ2
Length
整体蛋白的长度(包含Motif)。支持:
- 确定长度:
100 - 长度范围:
60-120
Number of Designs
设计的数量,默认 100。
Ligand
配体残基名,如:IAI,可指定多个,逗号分隔,如:ADP,MG,3PG
结果说明
输出成功过滤的设计结果 all_designed_successes.csv (若所有设计结果都未成功通过过滤,则输出已设计的结果 all_designed.csv) ,包含信息如下:
| 列名 | 含义 |
|---|---|
name |
设计结构的名称,使用design_N表示。 |
original_name |
设计过程中结构的原名称。 |
L |
设计的Binder长度(序列长度)。 |
self_complex_pLDDT |
复合物上的 pLDDT(局部结构置信度),越大越好。 |
self_complex_pTM |
复合物整体 pTM,越大越好。 |
self_complex_i_pTM |
界面 i_pTM,越大越好。 |
self_complex_pAE |
整体 pAE,通常越小越好。 |
self_complex_i_pAE |
界面 i_pAE,通常越小越好。CSV文件默认按该列进行升序排列。 |
self_complex_min_ipAE |
最小界面 PAE,越小越好。 |
self_complex_min_ipSAE |
界面 ipSAE 的最小值(与 PAE 互补的界面指标)。 |
self_complex_max_ipSAE |
界面 ipSAE 的最大值。 |
self_complex_avg_ipSAE |
界面 ipSAE 的平均值。 |
self_binder_scRMSD |
Binder 自洽 RMSD:重折叠后 binder 相对设计的偏差,越小越好。 |
self_complex_scRMSD |
复合物的自洽 RMSD,越小越好。 |
self_binder_scRMSD_ca |
Ca原子的Binder 自洽 RMSD:重折叠后 binder 相对设计的偏差,越小越好。 |
self_complex_scRMSD_ca |
复合物Ca原子的自洽 RMSD,越小越好。 |
self_ligand_scRMSD |
配体的自洽 RMSD,越小越好。 |
输出成功过滤的设计结果对应的Binder序列文件designed_successes_seqs.fasta(若无成功过滤的设计结果,则输出已设计结果对应的序列designed_seqs.fasta)
Protein模式中输出Batch格式的复合物序列文件complex_successes_seqs_batch.fasta或complex_seqs_batch.fasta
输出打包压缩文件all_designed_successes_structures.tar.gz或designed_res.tar.gz
参考文献
- Didi K, et al. Latent Generative Search Unlocks de novo Design of Untapped Biomolecular Interactions at Scale (2026).
- Didi K, et al. Scaling Atomistic Protein Binder Design with Generative Pretraining and Test-Time Compute, ICLR 2026. OpenReview

