
| 编号 | 529 | |
| 名称 | Protein Evolution | |
| 封面 |  | |
| 描述 | 蛋白进化分析,快速找到能够协同作用的多重突变组合,基于MULTI-evolve实现。 | |
| 标签 |
| |
| 作者 | Vincent Q. Tran | |
| 发布时间 | 2026-01-19 00:00:00 | |
| 参考文献 | Vincent Q. Tran et al. ,Rapid directed evolution guided by protein language models and epistatic interactions.[DOI:10.1126/science.aea1820](https://doi.org/10.1126/science.aea1820) | |
- 简介
- 参数说明
- Single Point Mutation
- Structure
- Chain
- TopN
- Positions Excluded
- Normalization
- Single Point Mutation File
- Multiple Point Mutations
- Structure
- Training Data
- Single Mutations
- Top variants
- Mutiple Point Mutation File
- 结果说明
- 参考文献
Protein Evolution
简介
蛋白进化分析,快速找到能够协同作用的多重突变组合。基于MULTI-evolve框架实现,面向蛋白工程中的候选突变发现与组合优化,提供单点突变与多点突变两种工作模式:前者利用蛋白语言模型进行零样本评估,快速发现潜在有利的单点突变;后者基于实验测得的突变数据训练监督模型,并在候选突变池上进一步搜索高阶组合突变。该流程将蛋白语言模型、表观互作(epistasis)建模和后续实验构建衔接为一套端到端方案;其中单点突变部分实际整合了 5 个 ESM-1v 模型(esm1v_t33_650M_UR90S_1-5)、1 个 ESM-2 3B 模型(esm2_t36_3B_UR50D),以及结构感知的 ESM-IF1,多点突变部分则以全连接神经网络为核心预测器来学习序列与性质之间的映射。
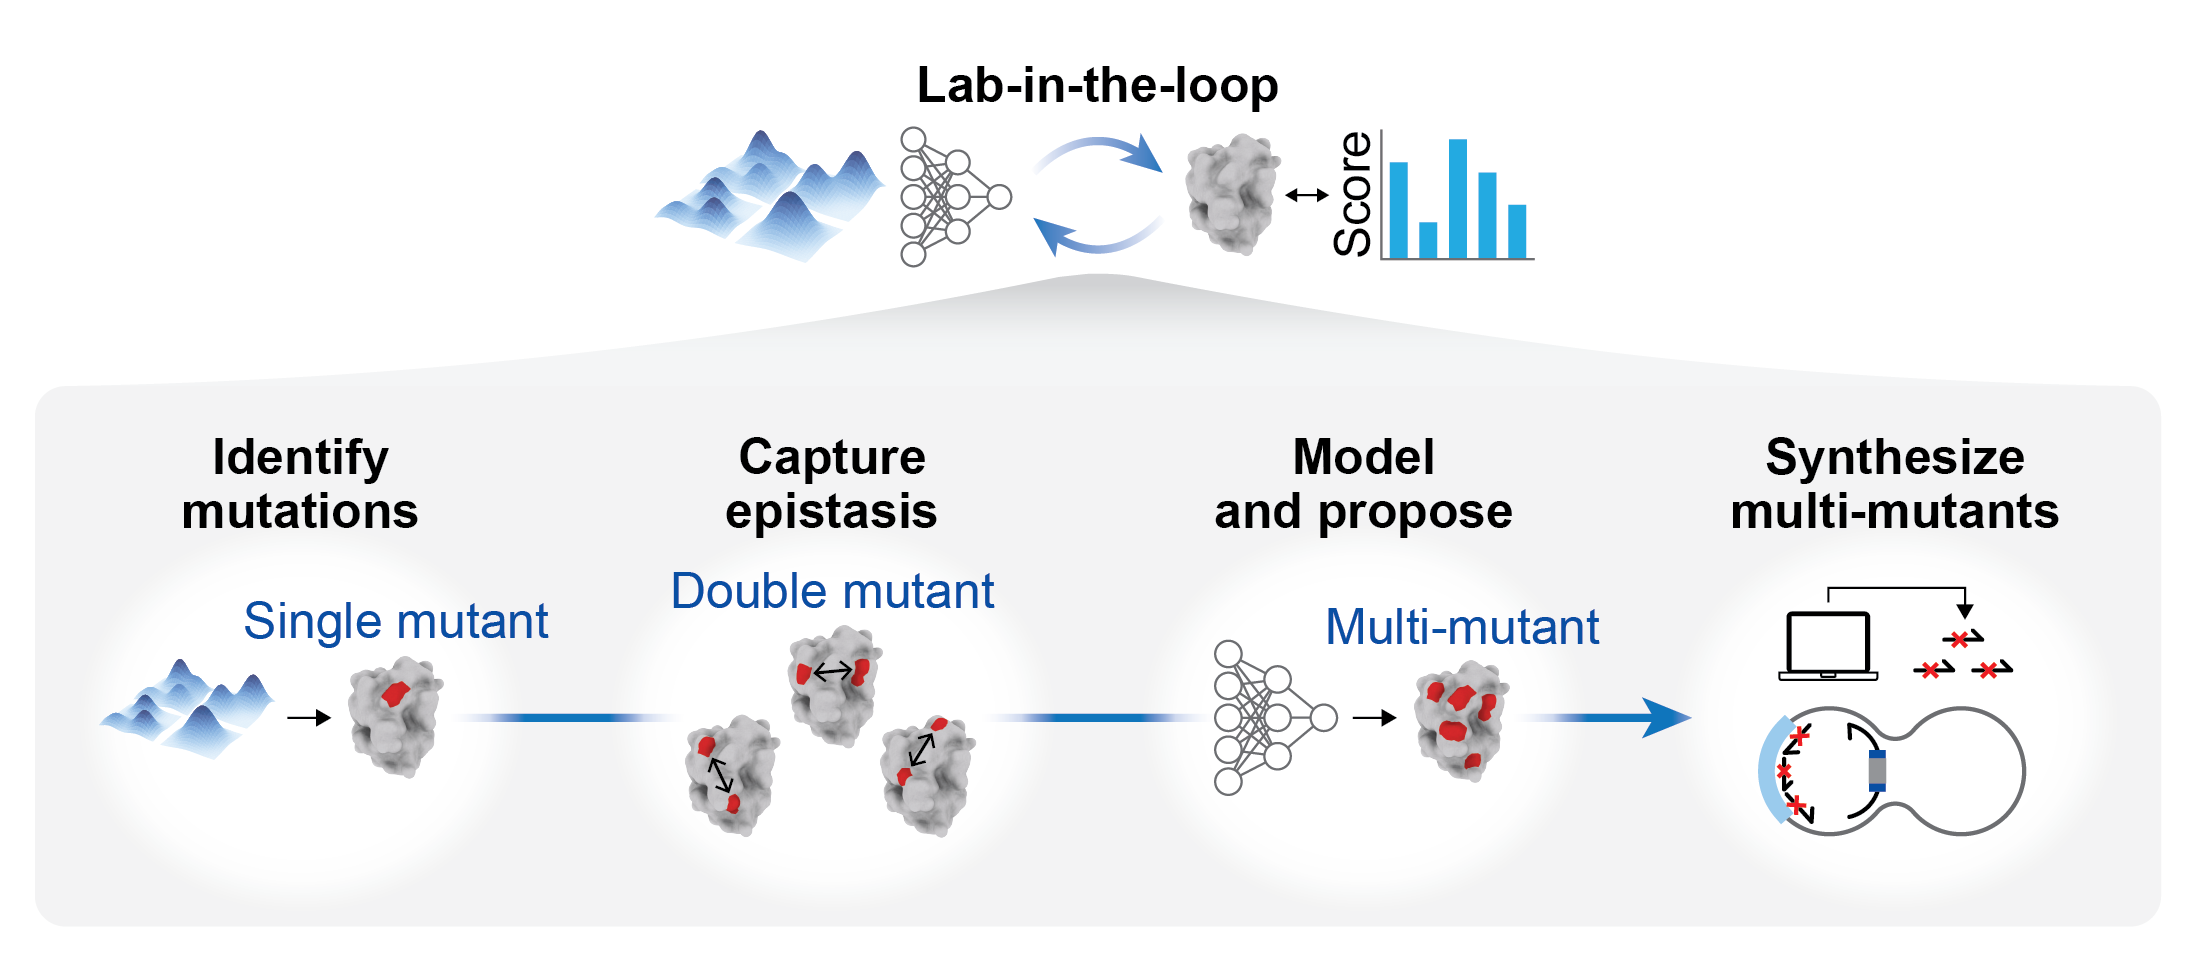
使用流程:
1,计算步骤,先使用单点突变模式,获取优势单点突变(一般选择排名靠前的15-20个)
2,湿实验步骤,对第一步选择的单点突变,及其所有两点突变的组合(100~200个组合),进行湿实验验证,获取突变对应的湿实验数据,请使用性质数据的比值(Fold-Change,FC值),即: 突变后的性质/野生型的性质。
3,计算步骤,使用多点突变模式,输入第二步的湿实验结果,进行模型训练,并预测多点突变组合对应的FC值,给出推荐的优势多点突变组合。
参数说明
Single Point Mutation
利用多个蛋白语言模型对蛋白单点突变的潜在效应进行突变概率预测,帮助研究者高效筛选更有希望进入后续实验验证的候选单点突变。模块并行提供 4 种筛选策略:ESM、ESM-IF、ESM-z 和 ESM-IF-z。突变位置从1开始按残基顺序编号。
- 在
ESM筛选中,每个 ESM 序列子模型都会在野生型序列背景下,分别计算目标位点上突变氨基酸与野生型氨基酸的条件概率,取对数后作差,得到该子模型对该单点突变的原始分数;随后再对所有序列子模型的分数取平均,作为最终的ESM综合得分。 - 在
ESM-IF筛选中,模型会结合输入的蛋白结构信息,对每个结构分别计算目标位点上突变残基与野生型残基的结构条件打分,并以两者差值作为该结构下的原始分数;当输入多个结构文件或多个构象时,再对各结构得到的分数取平均,作为最终的ESM-IF综合得分。 ESM-z和ESM-IF-z则是在对应原始得分的基础上,进一步进行 z-score 标准化处理,使不同突变位置之间的分数更便于横向比较与排序。
注意: z-score指的是一种标准化方法,模块提供了两种标准化方法,由Normalization控制。
Structure
输入蛋白结构文件,支持 PDB 或 CIF 格式,用于结构模型评分。支持输入同一结构的批量构象(需压缩文件格式,支持:.zip,.tar, .tar.gz, .tgz,.tar.bz2, .tbz2,.tar.xz, .txz),模块会分别计算每个构象中的突变评分,再取不同构象的平均值,以降低单一构象带来的偏差。
Chain
指定链名,进行单点突变推荐,多链时用逗号分隔,如A,B。如果不指定该参数,则对结构中的每条链都会进行单点突变推荐。
TopN
设置每种集成方法对每条链推荐的候选单点突变数量,默认20。
Positions Excluded
需排除的突变位点的位置,使用链名+残基位置编号(从1开始按顺序),如:A100表示A链中位置顺序编号100的残基进行排除。多位置时使用逗号分隔,支持范围符号,例如:A10-20,A25,B30-36,B40表示:排除A链编号10至20、25的残基,B链编号30至36、40的残基`。
Normalization
z-score 标准化的分组方式,可选 aa_substitution_type 和 aa_mutation,默认为:aa_substitution_type。
两种方法说明如下:
aa_substitution_type :按具体替换类型分组标准化。例如所有突变位置中, A→L的突变单独作为一组(如:A10L,A35L,A128L),所有G→V的突变为另一组;该方式更关注“从哪种氨基酸变成哪种氨基酸”。
aa_mutation : 按突变后的目标氨基酸分组标准化。例如 A10P、G25P、L80P 都会归到 P 这一组;该方式更关注“最终变成了什么氨基酸”。
Single Point Mutation File
指定输出结果csv文件的名称。默认:SP_Mutation.csv
Multiple Point Mutations
基于实验数据训练预测模型,对候选突变进行自动筛选与组合,生成可用于实验验证的优势多点突变方案。该模式的典型使用场景是:先通过单点或双点突变实验获得一定规模的功能数据,再训练模型预测更高阶组合突变(通常为 >=3 位点)的潜在表现。
Structure
输入蛋白结构文件,支持 PDB 或 CIF 格式。
Training Data
输入.csv格式文件,CSV必须包含以下列:
mutation :指定结构中的突变信息,使用原始残基+链名+残基位置编号(从1开始按顺序)+突变后的残基,如:KA100N表示A链中位置顺序编号100的残基K,突变为N。多点突变时用分号分隔,如:GA48R;DB106A
property : 突变对应的性质变化倍数,即性质数据的比值(Fold-Change,FC值),即: 突变后的性质/野生型的性质。
注意:
1.突变样本数量需要大于20条
2.模块会对输入内容进行检查;若存在数据错误,请查看 stderr.txt。
Single Mutations
用于进行多点组合突变的单点突变文件,同样使用原始残基+链名+残基位置编号(从1开始按顺序)+突变后的残基,输入格式如下:
TA192V
TB192K
AC167R
NA72A
注意:
1.如果不指定该参数,默认会将训练数据中的所有单点突变,进行组合,然后预测推荐。
2.模块会对输入内容进行检查;若存在数据错误,请查看 stderr.txt。
Top variants
指定为每类组合突变推荐的TopN数量,默认为:3,即:三点组合突变推荐3个,四点组合突变推荐3个,五点组合突变推荐3个,…,最多推荐十点组合突变。
Mutiple Point Mutation File
指定输出结果csv文件的名称。默认:MP_Mutation.csv
结果说明
单点突变模式下,结果输出SP_Mutation.csv,内容如下:
| Chain ID | Mutations | ESM | ESM-IF | ESM-z | ESM-IF-z | Count |
|---|---|---|---|---|---|---|
| A | F26L | 1 | 0 | 1 | 1 | 3 |
| A | A167R | 1 | 0 | 1 | 0 | 2 |
| A | A250D | 0 | 1 | 0 | 1 | 2 |
| … |
说明:
| 字段 | 说明 |
|---|---|
| Chain ID | 当前推荐突变所属链 ID |
| Mutations | 单点突变名称,格式通常为“野生型氨基酸 + 位点 + 突变后氨基酸”,如 F26L 表示第 26 位(从1开始的位置顺序编号)由 F 突变为 L |
| ESM | 是否被 ESM 方法推荐,1 表示是,0 表示否 |
| ESM-IF | 是否被 ESM-IF 方法推荐,1 表示是,0 表示否 |
| ESM-z | 是否被 ESM-z 方法推荐,1 表示是,0 表示否 |
| ESM-IF-z | 是否被 ESM-IF-z 方法推荐,1 表示是,0 表示否 |
| Count | 该突变被多少种方法共同推荐,为各方法标记值之和 |
- 模块基于
ESM、ESM-IF、ESM-z和ESM-IF-z4 种推荐方法对饱和单点突变进行筛选,每种推荐方法均按照对应的打分规则对候选突变进行排序,并依次选取前TopN个且位点不重复的突变作为推荐结果;被推荐的突变在对应列中记为1,未被推荐则记0
在多点突变模式下,结果输出MP_Mutation.csv,结果内容如下:
| Variant ID | Chain ID | Mutations Number | Mutations | Sequence | Average |
|---|---|---|---|---|---|
| 399 | A | 3 | N72A/A167R/T192K | MGKSYPTVSADYQDAVEKAKKKLRGFIAEKRCAPLMLRLAFHSAGTFDKGTKTGGPFGTIKHPAELAHSANAGLDIAVRLLEPLKAEFPILSYADFYQLAGVVAVEVTGGPKVPFHPGREDKPEPPPEGRLPDATKGSDHLRDVFGKAMGLTDQDIVALSGGHTIGRAHKERSGFEGPWTSNPLIFDNSYFKELLSGEKEGLLQLPSDKALLSDPVFRPLVDKYAADEDAFFADYAEAHQKLSELGFADA | 0.7711919 |
| 405 | A | 3 | A167R/T192K/D222E | MGKSYPTVSADYQDAVEKAKKKLRGFIAEKRCAPLMLRLAFHSAGTFDKGTKTGGPFGTIKHPAELAHSANNGLDIAVRLLEPLKAEFPILSYADFYQLAGVVAVEVTGGPKVPFHPGREDKPEPPPEGRLPDATKGSDHLRDVFGKAMGLTDQDIVALSGGHTIGRAHKERSGFEGPWTSNPLIFDNSYFKELLSGEKEGLLQLPSDKALLSDPVFRPLVEKYAADEDAFFADYAEAHQKLSELGFADA | 0.754778 |
| 201 | A | 4 | L11Q/A40P/S63A/T116L | EVQLVESGGGQVQPGGSLRLSCAASGFTFSDFYMEWVRQPPGKGLEWIAASRNKANDYTTEYAASVKGRFIVSRDDSKNSLYLQMNSLKTEDTAVYYCARSYYRYDGMDYWGQGTLVTVSS:EIVLTQSPATLSLSPGERATLSCSAISSVSYMYWYQQKPGQAPRLLIYDTSNLVSGVPARFSGSGSGTDYTLTISSLEPEDFAVYYCQQWNTYPYTFGGGTKVEIK | 0.63438326 |
| 460 | A;B | 4;1 | Q13P/A40P/S63A/T116L;I105L | EVQLVESGGGLVPPGGSLRLSCAASGFTFSDFYMEWVRQPPGKGLEWIAASRNKANDYTTEYAASVKGRFIVSRDDSKNSLYLQMNSLKTEDTAVYYCARSYYRYDGMDYWGQGTLVTVSS:EIVLTQSPATLSLSPGERATLSCSAISSVSYMYWYQQKPGQAPRLLIYDTSNLVSGVPARFSGSGSGTDYTLTISSLEPEDFAVYYCQQWNTYPYTFGGGTKVELK | 0.67288095 |
| … |
说明:
| 字段 | 说明 |
|---|---|
| Variant ID | 候选变体编号,与 all 结果文件中的编号一致。all 结果将包含在结果打包文件中 |
| Chain ID | 当前结果中实际发生突变的链 ID;单链或仅单条链发生突变时为单个链名,如 A;多条链同时突变时按字母顺序使用分号 ; 分隔 |
| Mutations Number | 突变数量;仅单条链发生突变时为单个数字;多条链同时突变时按链顺序使用分号 ; 分隔 |
| Mutations | 突变信息;链内多个突变使用 / 分隔;多条链同时突变时使用分号 ; 连接各链突变信息 |
| Sequence | 被筛选变体对应的氨基酸序列;多链情况下按链顺序使用冒号 : 分隔 |
| Average | 被筛选变体的综合平均预测得分,数值越高表示该变体预测表现越优 |
同时,输出 MP_Mutation.tar.gz,其中包含最终合并结果 CSV。压缩包内包含以下文件:
MP_Mutation.csvMP_Mutation_all.csv
其中,MP_Mutation_all.csv 为全部筛选变体的完整结果文件。
参考文献
- Vincent Q. Tran et al. ,Rapid directed evolution guided by protein language models and epistatic interactions.DOI:10.1126/science.aea1820

