
| 编号 | 525 | |
| 名称 | Protein Contacts Profile | |
| 封面 |  | |
| 描述 | 对结构预测模型(如:Boltz2/Protenix/AF3等)预测的一组蛋白单体或复合物结构进行全面分析,包括:二级结构、溶剂可及性、疏水性、残基接触、结构置信度等等,对分析结果进行统一整理和对比展示。 | |
| 标签 |
| |
| 作者 | WECOMPUT | |
| 发布时间 | 2026-04-24 00:00:00 | |
| 参考文献 | Robert, X., Guillon, C. and Gouet, P. (2025) FoldScript: a web server for the efficient analysis of AI-generated 3D protein models, Nucleic Acids Res., 53(W1):W277-W282, DOI: https://doi.org/10.1093/nar/gkaf326
https://foldscript.ibcp.fr | |
- 简介
- 参数说明
- Structures
- Sequence database
- E-value
- Homolog Display Limit
- Columns
- VDW
- Numbering Type
- Exclude Intra Antibody
- Contact Distance Cutoff
- Strong Contact Distance Cutoff
- Contact Consensus Threshold
- Contact Chains
- Contact Its
- CDR Only
- 结果说明
- 参考文献
Protein Contacts Profile
简介
对结构预测模型(如:Boltz2/Protenix/AF3等)预测的一组蛋白单体或复合物结构进行全面分析,包括:二级结构、溶剂可及性、疏水性、残基接触、结构置信度等等,对分析结果进行统一整理和对比展示。
核心思路:以参考链为分析目标,将二级结构、溶剂可及性、疏水性、残基接触、模型置信度,以及可选的同源序列和保守性信息等等汇总到同一份报告中。
模块工作流 :
- Gemmi:用于读取 PDB/mmCIF 结构,并从查询模型中规范化链、残基、原子和实体类型。
- DSSP:通过提取每个残基的二级结构和溶剂可及性。
- 二硫键计算模块:根据模型坐标计算以残基为中心的接触注释,并推断二硫键。
- Kyte-Doolittle 疏水性评分:逐一计算残基疏水性。
- 类 pLDDT 的置信度提取:当输入模型将置信度编码在原子的 B-factor字段中时,提取残基置信度数值。
- BLAST+:在配置好的本地序列数据库中搜索同源蛋白序列。
- Clustal Omega:对查询序列和命中序列进行比对,进行保守性分析。
- 相互作用类型:对残基对相互作用进行跨结构统计,生成CSV文件,比较不同结构之间相互作用出现的频率与类型。
- 统计汇总:基于上述分析结果,汇总输出多个CSV文件。
- HTML 渲染:将上述分析结果渲染为交互式 HTML 报告和按链导出的 PDF。
相互作用类型判断的阈值:
| 相互作用类型 | 相互作用表示的编号 | 对应阈值 |
|---|---|---|
| 疏水接触 | hp |
先筛选疏水残基或 ligand 中仅与 C/H 相邻的碳原子,并用 < 3.9 Å 生成候选接触;最终以原子间距 < RvdW(A)+RvdW(B)+0.5 Å 判定。 |
| 盐桥 | sb |
距离 < 4.0 Å。 |
| π-阳离子 | pc |
距离 < 6.0 Å,角度 < 60°。 |
| π-π 堆积 | ps |
中心距 < 7.0 Å,法向角 < 30°;ψ角 < 45°。 |
| T-stacking | ts |
中心距 < 5.0 Å,相对 90° 的法向偏差 < 30°;ψ角 < 45°。 |
| 范德华接触 | vdw |
任意非氢原子之间的接触,原子间距 < RvdW(A)+RvdW(B)+0.5 Å。 |
| 直接氢键 | hbbb / hbsb / hbss / hblb / hbls / hbll |
D–A 距离 < 3.5 Å,静态结构默认角度阈值 180°。 |
| 水桥氢键 | wb / lwb |
每一段氢键距离< 3.5 Å,角度 > 110°。 |
| 扩展水桥氢键 | wb2 / lwb2 |
每一段氢键距离< 3.5 Å,角度> 110°。 |
参数说明
Structures
输入蛋白结构,允许单个以及批量输出。单结构输入,支持 .pdb、.cif、.mmcif 结构格式批量输入需要以压缩包的形式,支持:.zip、.tar、.tar.gz、.tgz、.tar.bz2、.tbz2、.tar.xz、.txz,批量输入最大支持100个结构。
Sequence database
指定通过BLAST+搜索筛选的序列数据库。可选:SwissProt(UniProt知识库中的Swiss-Prot数据库)和 PDBAA(从实验确定的三维结构数据库PDB衍生的序列)。
E-value
指定BLAST+搜索识别序列匹配的保留阈值。E值表示给定序列比对的统计显著性。E值越低(越接近零),匹配的显著性越高,可选阈值:
1e-4、1e-5、1e-6、1e-7、1e-8、1e-9、1e-10、1e-11、1e-12。默认:1e-6
Homolog Display Limit
设置在序列搜索时,保留的最大序列数,可选数量:1~25。默认:5
Columns
指定一行序列展示的残基数量。默认:120
VDW
分析相互作用时,是否输出范德华相互作用,默认输出,选中表示不输出。
Numbering Type
指定抗体 CDR 标注默认使用的编号方案。可选:Kabat、IMGT、Chothia。默认:Kabat。
Exclude Intra Antibody
指定在额外提取 second-shell 和 anchor 残基时,是否排除可识别的抗体重链-轻链内部 contact。默认:True。在抗原-抗体复合物中,默认只考虑抗体-抗原之间的 contact;如需纳入抗体重链-轻链之间的内部 contact,可设置为 False。
Contact Distance Cutoff
设置残基接触对判断的距离阈值。默认:4.0
Strong Contact Distance Cutoff
设置残基强接触对判断的距离阈值。默认:3.2
Contact Consensus Threshold
设置共同残基的统计阈值,以筛选在输入的批量结构中出现频率高于该阈值的相互作用残基。默认:0.5
Contact Chains
指定额外提取contacts残基时,对应的链名,多链用逗号分隔。默认:None
Contact Its
指定额外提取contacts残基时,排除的相互作用类型,多类型用逗号分隔。如果残基存在指定的相互作用类型,则不提取。默认:hp、sb、pc、ps、ts、hbbb、hbsb、hbss、hblb、hbls、hbll。需要配合Contact Chains使用,Contact Chains不指定时不起效。
CDR Only
指定在额外提取 second-shell 和 anchor 残基时,是否只保留 CDR 区域内的残基。默认:False。设置为 True 时,会使用当前 Numbering Type 对应的 CDR 区间进行判断,仅输出属于 CDR 的残基。需要配合Contact Chains使用,Contact Chains不指定时不起效。
结果说明
输出protein_contacts_profile.html,内容展示如下:
注意: 若输入超过80个结构,HTML文档有可能过大而导致浏览器无法正常显示。
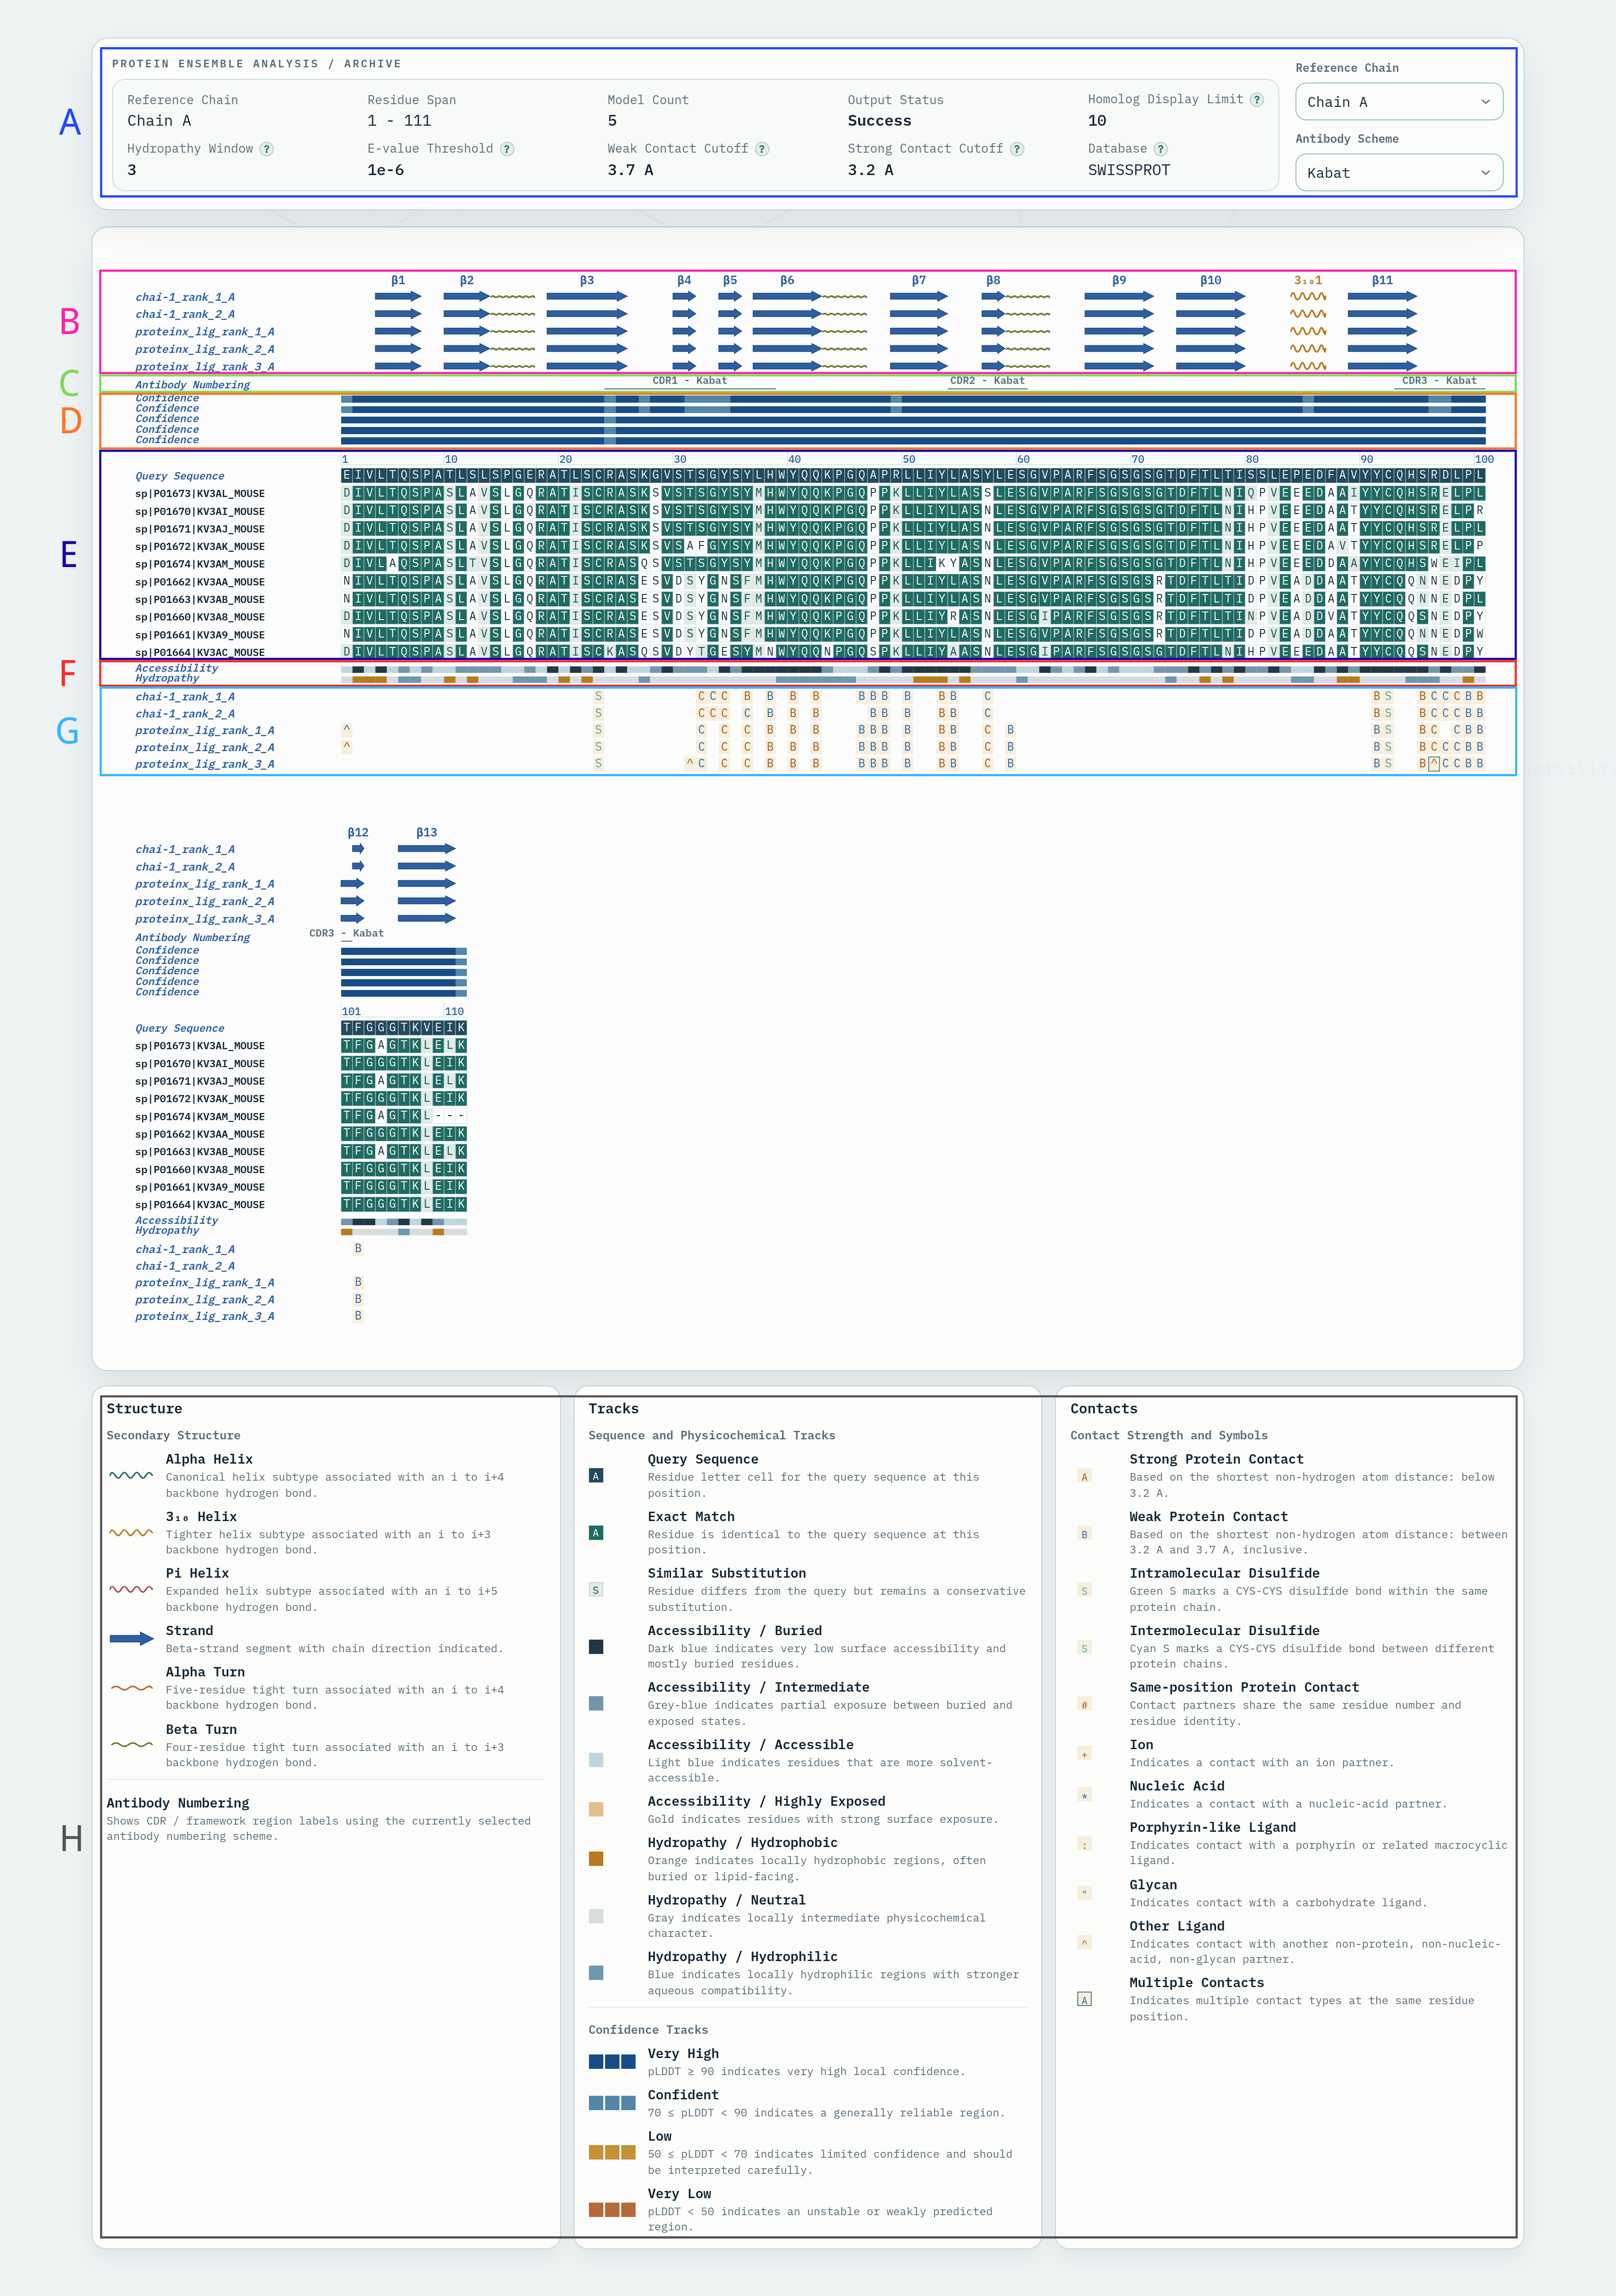
说明:
A. 摘要
在图的最上方,是当前活动面板的摘要区。
Reference Chain表示当前正在查看的参考链;Residue Span表示这条链在图中覆盖的残基范围;Model Count表示本次一起参与比较的模型数量;Output Status表示当前链面板的结果状态;Weak Contact Cutoff和Strong Contact CutoffHydropathy Window、E-value Threshold、Weak Contact Cutoff、Strong Contact Cutoff、Homolog Display Limit和Database则对应这张图生成时使用的关键参数,说明如下:
| 参数 | 默认值 | 说明 |
|---|---|---|
Hydropathy Window |
3 |
疏水性平滑窗口大小,用于计算 Kyte-Doolittle hydropathy。值越大,曲线越平滑;值越小,越能反映局部波动。应为正整数。 |
E-value Threshold |
1e-6 |
表示指定BLAST+搜索识别序列匹配的保留阈值E-value,E值越低(越接近零),匹配的显著性越高。 |
Weak Contact Cutoff |
4.0 Å |
弱接触的距离上限,按非氢原子之间的最短距离判断。只有当最短距离 <= 4.0 Å 时,残基间才会被视为存在接触。通常表示“接触判定的外层阈值”。 |
Strong Contact Cutoff |
3.2 Å |
强接触的距离阈值,按非氢原子之间的最短距离判断。当最短距离 < 3.2 Å 时记为强接触;否则若仍在 weak cutoff 内,则记为弱接触。 |
Homolog Display Limit |
5 |
最多检索并展示多少条同源序列。取值范围为 0-25;设为 0 时会跳过 homolog search,只保留 query 序列本身。 |
Database |
SWISSPROT |
用于同源搜索的数据库,PDBAA和SWISSPROT。 |
B. 二级结构与置信度
在结构部分,每个模型都会用图形标出参考链上的二级结构单元。
Alpha Helix、3₁₀ Helix和Pi Helix都用卷曲波浪线表示,颜色不同,分别对应α螺旋、3₁₀螺旋和π螺旋。Strand用箭头表示,箭头方向反映链段方向。Alpha Turn和Beta Turn则表示两类更短的紧转角区域,通常出现在连接不同二级结构的局部片段中。
如果输入结构中带有逐残基置信度信息,结构轨道还会按 pLDDT 着色。
- 深蓝色表示
pLDDT >= 90,通常可以把这部分看作局部较可信的区域; - 青蓝色表示
70 <= pLDDT < 90,整体骨架往往已经比较可靠; - 黄色表示
50 <= pLDDT < 70,说明这一段需要更谨慎地解释; - 橙红色表示
pLDDT < 50,这类区域往往更灵活,也更容易出现不稳定或低置信度的构象。
把“结构形态”和“置信度颜色”结合起来看:如果某个螺旋或链段在不同模型里都出现,但颜色差异明显,就说明该局部形态可能存在不确定性。
C. 如果当前参考链被识别为抗体样链,还会额外显示一条 Antibody Numbering 轨道,并在界面中提供 Kabat、IMGT、Chothia 三种编号方案切换。
- 这条轨道主要用来标出抗体可变区中的
CDR1、CDR2、CDR3位置,帮助快速判断互补决定区落在序列的哪一段; - 切换编号方案时,变化的是 CDR 的边界定义和标签归属,而不是原始氨基酸序列本身;
- 若参考链被识别为重链,则这些 CDR 标记对应重链可变区;若被识别为轻链,则对应轻链可变区;
如果序列并不像抗体可变区,或者当前环境无法完成抗体编号,这条轨道可能不会显示。
D. 序列与同源信息
在结构轨道下方,报告会显示参考链的序列轴。
Query Sequence表示目标序列本身;Exact Match表示该位置与查询序列完全一致;`Similar Substitution表示氨基酸虽然不同,但仍属于较保守的替换。
阅读时,它能帮助你区分“模型之间结构有差异,但序列背景本身很保守”和“这一段本来就在同源序列里变化较大”这两种情况。
E. Accessibility与Hydropathy
在序列信息下面,报告会显示两条理化性质轨道。
Accessibility 用来表示残基在结构表面的暴露程度。
- 深蓝色对应埋藏程度较高的区域;
- 灰蓝色表示中间状态;
- 浅蓝色表示更容易暴露于溶剂环境;
- 金色则提示该位置表面暴露很明显;
对于结构分析,这条轨道适合用来判断一个位点更像是核心残基、表面残基,还是潜在的界面区域。
Hydropathy 则描述序列在局部窗口中的疏水或亲水倾向。
- 橙色表示偏疏水,常见于埋藏区、界面内部或与脂质环境相容的区域;
- 灰色表示性质居中;蓝色表示偏亲水,更常出现在暴露于水相环境的位置;
这条轨道结合
Accessibility轨道一起观察,能更好的判断某一段结构是否符合直觉:例如,一个明显暴露的区域如果同时又很疏水,就值得进一步留意它是否参与界面作用或是否处在特殊构象环境中。
F. 接触与符号
接触轨道用来描述参考链残基与其他链、配体或小分子的相互作用。
蛋白-蛋白接触使用字母显示,字母表示接触对方所在的链。颜色用于区分接触强度:
- 较深的接触标记对应强接触,当前阈值为最短非氢原子距离小于
3.2 Å; - 较浅的标记对应弱接触,距离位于
3.2 Å到4.0 Å之间。 - 若同一个位点同时存在多种接触,图中还会用额外外框加以标识,提醒这一位置可能处在更复杂的界面环境里;
除了链字母,轨道里还会出现一些专门的符号。
S用来标记二硫键;绿色通常表示链内二硫键,青色表示链间二硫键;#表示接触对方与当前位置具有相同的残基编号和残基类型,常见于对称相关的接触关系;- 对于非蛋白组分,模块也会用符号做简写显示,例如核酸、离子、糖类、卟啉样配体或其他小分子;参考下方的
符号对照表
建议先看“有没有接触”,再看“接触对象是谁”,最后再结合结构轨道判断这些接触是否稳定、是否集中出现在同一个局部区域。
符号对照表:
| 符号 | 说明 |
|---|---|
A-Z / a-z |
与对应链发生蛋白-蛋白接触 |
S |
二硫键位置 |
# |
与同编号、同类型残基发生对应接触 |
* |
与核酸接触 |
+ |
与离子接触 |
: |
与卟啉样或相关大环配体接触 |
" |
与糖类配体接触 |
^ |
与其他小分子或杂项配体接触 |
G. 底部图例
分成三列:
- 左侧
Structure主要解释螺旋、折叠链和转角这些结构符号以及抗体编号; - 中间
Tracks主要解释序列比对、可及性、疏水性和置信度颜色; - 右侧
Contacts主要解释强弱接触、二硫键和各类配体符号。
输出cross_structure_interaction.csv,示例如下:
| Chain | Residue | Pos | Other_Chain | Other_Residue | Other_Pos | Structures | Count | Interaction Types |
|---|---|---|---|---|---|---|---|---|
| B | R | 38 | B | E | 46 | 1;2;3;4;5 | 5 | sb |
| C | K | 105 | C | W | 2 | 1;2;3;4;5 | 5 | pc |
| C | F | 22 | C | F | 7 | 1;2;3;4;5 | 5 | ps |
| B | Y | 27 | B | Y | 32 | 1;2;3;4;5 | 5 | ts |
| B | R | 38 | D | ATP | 1 | 3;4;5 | 3 | pc |
说明:
| 字段 | 说明 |
|---|---|
| Chain | 第一个残基所在链。 |
| Residue | 第一个残基名。蛋白残基使用一字母缩写;非蛋白残基保留其紧凑名称,例如 MG。 |
| Pos | 第一个残基从1开始的顺序编号。 |
| Other_Chain | 另一残基所在链。 |
| Other_Residue | 另一残基名。 |
| Other_Pos | 另一残基从1开始的顺序编号。 |
| Structures | 观察到该残基对接触的结构编号列表,编号从1开始,使用分号 ; 分隔。 |
| Count | Structures 中结构编号的数量。 |
| Interaction Types | 该残基对在所有命中结构中观察到的相互作用类型汇总,使用分号 ; 分隔。 |
注意: 结构编号为
protein_contacts_profile.html中结构名称自上而下,并且从1开始编号的标识
补充说明:
- 该表由
Cross-Structure Interaction Comparison功能汇总生成,用于从跨结构比较相同残基对在不同模型中的保留情况。 - 表格按
Count从高到低排序,越靠前的残基对,说明在更多结构中重复出现。 - 当同一残基对在不同结构中出现多种相互作用时,
Interaction Types会以分号汇总展示。
输出contact_details.csv,示例如下:
| Chain | Residue | Pos | Other_Chain | Other_Residue | Other_Pos | Structures | Distances | Distance_Avg | Interaction Types |
|---|---|---|---|---|---|---|---|---|---|
| A | Y | 34 | C | S | 32 | 1;2;3;4;5 | 3.34;3.32;3.00;3.31;3.39 | 3.27 | |
| A | H | 38 | B | D | 104 | 1;2;3;4;5 | 3.69;3.95;2.95;2.98;2.95 | 3.30 | sb |
| A | Q | 46 | B | Y | 95 | 1;2;3;4;5 | 3.57;3.71;3.41;3.46;3.48 | 3.53 | |
| A | R | 96 | C | E | 54 | 1;4;5 | 3.74;3.60;3.99 | 3.77 | sb |
| B | R | 99 | C | D | 55 | 2;3;4;5 | 3.74;2.77;2.82;2.84 | 3.04 | sb |
说明:
| 字段 | 说明 |
|---|---|
| Chain | 第一个残基所在链。 |
| Residue | 第一个残基的一字母缩写。 |
| Pos | 第一个残基从1开始的顺序编号。 |
| Other_Chain | 与第一个残基形成接触的另一残基所在链。 |
| Other_Residue | 另一残基的一字母缩写。 |
| Other_Pos | 另一残基从1开始的顺序编号。 |
| Structures | 观察到该残基对接触的结构编号列表,编号从1开始,使用分号 ; 分隔。 |
| Distances | 各结构中该残基对的最小接触距离,顺序与 Structures 对应。 |
| Distance_Avg | Distances 中所有距离值的平均值。 |
| Interaction Types | 相互作用类型,使用分号 ; 分隔;未匹配时为空。 |
注意: 结构编号为
protein_contacts_profile.html中结构名称自上而下,并且从1开始编号的标识
输出contact_residue_details.csv,示例如下:
| Chain | Residue | Pos | SASA_Rel_Avg | All | … |
|---|---|---|---|---|---|
| A | E | 1 | 0.68 | 0.40 | … |
| A | S | 32 | 0.34 | 1.00 | … |
| A | Y | 34 | 0.04 | 1.00 | … |
| A | Q | 46 | 0.51 | 1.00 | … |
| A | Q | 93 | 0.09 | 0.60 | … |
| B | S | 7 | 0.21 | 0.40 | … |
说明:
| 字段 | 说明 |
|---|---|
| Chain | 该残基所在的链。 |
| Residue | 残基类型。 |
| Pos | 残基从 1 开始的顺序编号。 |
| SASA_Rel_Avg | 该残基在所有结构中的平均相对溶剂可及表面积,取值范围为 0.00 至 1.00。 |
| Domain (Kabat/IMGT/Chothia) | 若该链为抗体链,显示该残基对应的 CDR 区域。 |
| All / Cluster_n | 该残基在全部结构中/某个结构簇内作为接触残基出现的频率,取值范围为 0.00 至 1.00。示例中,All 列的值为 0.40,表示该残基在全部结构的 40% 中被识别为接触残基。若存在多个结构簇,还会增加 Cluster_1、Cluster_2 等列。 |
输出contact_consensus.csv,示例如下:
| Cluster Id | Structure Count | Cluster Center | Combine Count | Consensus Count | Combine Residue | Consensus Residue | Consensus Residue (Threshold) |
|---|---|---|---|---|---|---|---|
| All | 5 | proteinx_lig_rank_1 | 87 | 52 | A1;A31-34;A36;A38;A40;A42;A46-48;A50;A53-54;A57;A59;A91;A95-100;A102;B7-10;B1… | A32;A34;A36;A38;A40;A42;A47-48;A50;A53-54;A57;A91;A95-96;A98-100;B33;B35;B39;… | A32;A34;A36;A38;A40;A42;A46-48;A50;A53-54;A57;A59;A91;A95-100;A102;B30;B33;B3… |
说明:
| 字段 | 说明 |
|---|---|
| Cluster Id | 统计范围标识。All 表示基于全部结构的全局统计;若存在多个结构簇,还会出现 Cluster_1、Cluster_2 等簇级结果。 |
| Structure Count | 当前统计范围内参与汇总的结构数量。 |
| Cluster Center | 当前簇的中心结构名。对于 All 行,当结果中只有一个结构簇时,这里会显示该簇的中心结构;若存在多个结构簇,则该字段可能为空。 |
| Combine Count | 当前范围内接触残基并集的数量。 |
| Consensus Count | 当前范围内接触残基交集的数量。 |
| Combine Residue | 接触残基并集列表。残基编号使用从1开始的顺序编号,并保留链前缀;连续区间会压缩为 A31-34 这种格式。 |
| Consensus Residue | 在当前范围内所有结构中都出现过接触的残基列表,格式与 Combine Residue 相同。 |
| Consensus Residue (Threshold) | 达到接触出现频率阈值的残基列表,格式与 Combine Residue 相同。默认阈值为 0.5,可通过 Contact Consensus Threshold 调整。 |
输出tm_clusters.csv,示例如下:
| Structure | Cluster Id | Cluster Size | Cluster Center | Is Representative |
|---|---|---|---|---|
| chai-1_rank_1 | 1 | 5 | proteinx_lig_rank_1 | 0 |
| chai-1_rank_2 | 1 | 5 | proteinx_lig_rank_1 | 0 |
| proteinx_lig_rank_1 | 1 | 5 | proteinx_lig_rank_1 | 1 |
| proteinx_lig_rank_2 | 1 | 5 | proteinx_lig_rank_1 | 0 |
| proteinx_lig_rank_3 | 1 | 5 | proteinx_lig_rank_1 | 0 |
说明:
| 字段 | 说明 |
|---|---|
| Structure | 当前结构名,不带文件后缀。 |
| Cluster Id | 该结构所属的 TM-score 簇编号。 |
| Cluster Size | 该结构所在簇的成员数量。 |
| Cluster Center | 该结构所在簇的中心结构名。 |
| Is Representative | 是否为该簇的代表结构;1 表示是,0 表示否。 |
输出tm_score_matrix.csv,示例如下:
| Structure | chai-1_rank_1 | chai-1_rank_2 | proteinx_lig_rank_1 | proteinx_lig_rank_2 | proteinx_lig_rank_3 |
|---|---|---|---|---|---|
| chai-1_rank_1 | 1.00 | 1.00 | 0.97 | 0.97 | 0.97 |
| chai-1_rank_2 | 1.00 | 1.00 | 0.98 | 0.98 | 0.98 |
| proteinx_lig_rank_1 | 0.97 | 0.98 | 1.00 | 1.00 | 1.00 |
| proteinx_lig_rank_2 | 0.97 | 0.98 | 1.00 | 1.00 | 1.00 |
| proteinx_lig_rank_3 | 0.97 | 0.98 | 1.00 | 1.00 | 1.00 |
说明:
| 字段 | 说明 |
|---|---|
| Structure | 行对应的结构名。 |
其余结构列(如 boltz_rank_1、chai-1_rank_1) |
每一列的列名也是一个结构名;单元格的值表示该行结构与该列结构之间的 TM-score。 |
补充说明:
- 这是一个对称矩阵。
- 对角线上的值恒为
1.0。 - 非对角线数值越高,表示两个结构越相似。
输出selected_contact_residues.txt,内容为指定Contact Chains中筛选得到的 contact 残基。筛选时会根据Contact Its参数进行排除:如果某个残基存在 Contact Its 中指定的相互作用类型,则该残基不会被写入结果文件,最终仅保留不包含指定相互作用类型的残基。示例如下:
A30-32,A39,A43-45,A47,A52-54,A57,A95,A100-102,A104-108,A110-112,A129-135,A144,A146,A148,A150,A171-174,A176,A178,A185-187,A220-221,B34,B36,B38,B43-44,B46,B49-50,B52-54,B56,B87,B89,B91-95,B98,B116-121,B124,B127,B131,B133,B135,B137-138,B160-164,B174-176,B180,B209,B214
输出selected_second-shell_residues.txt,内容为指定Contact Chains中筛选得到的 second-shell contact 残基。筛选时会根据Contact Its参数进行排除:如果某个残基存在Contact Its中指定的相互作用类型,则该残基不会被写入结果文件,最终仅保留不包含指定相互作用类型的残基。默认还会根据Exclude Intra Antibody排除可识别的抗体重链-轻链内部 contact。示例如下:
A30-32,A39,A43-45,A47,A52-54,A57,A95,A100-102,A104-108,A110-112,A129-135,A144,A146,A148,A150,A171-174,A176,A178,A185-187,A220-221,B34,B36,B38,B43-44,B46,B49-50,B52-54,B56,B87,B89,B91-95,B98,B116-121,B124,B127,B131,B133,B135,B137-138,B160-164,B174-176,B180,B209,B214
输出selected_anchor_residues.txt,内容为指定Contact Chains中被Contact Its参数排除的contact残基,即带有指定相互作用类型的anchor 残基。默认同样会根据Exclude Intra Antibody排除可识别的抗体重链-轻链内部contact。输出格式同selected_second-shell_residues.txt文件。
另外,还会输出一个protein_contacts_profile_results.tar.gz,会包含protein_contacts_profile.html以及各参考链的PDF与结果CSV。
参考文献
- Robert, X., Guillon, C. and Gouet, P. (2025) FoldScript: a web server for the efficient analysis of AI-generated 3D protein models, Nucleic Acids Res., 53(W1):W277-W282, DOI: https://doi.org/10.1093/nar/gkaf326
- https://foldscript.ibcp.fr

