PPI Binding Energy (Graphomer)
简介
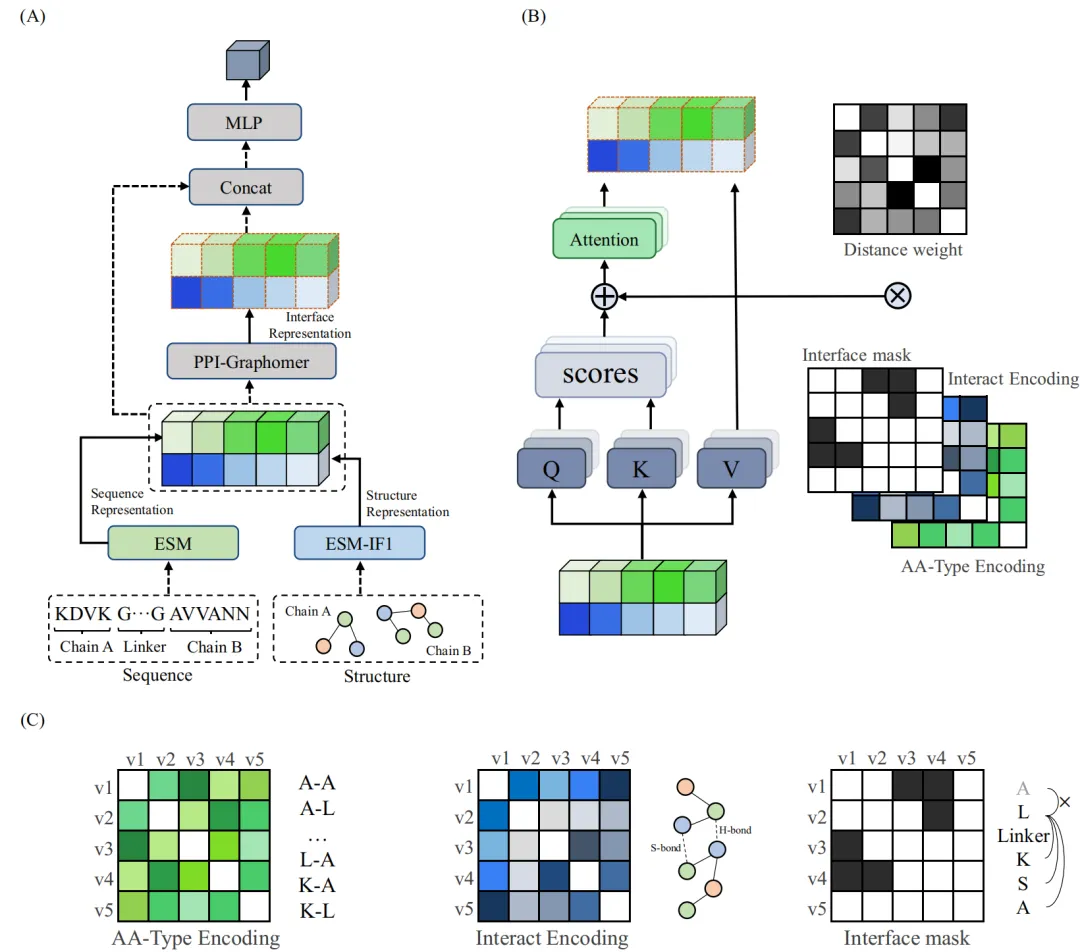
基于PPI-Graphomer模型预测蛋白-蛋白结合亲和力,该模型是一种专门感知界面残基作用的Graph Transformer模型,同时结合了多模态预训练模型,效果显著优于已有主流方法。
模型设计采用:序列 + 结构 + 图神经网络三合一
步骤一:特征提取,蛋白语言模型 + 结构模型协同
- 使用ESM2(蛋白语言模型)用于提取蛋白序列中的进化和语义特征(1280 维 → 64 维);
- 使用ESM-IF1(结构到序列逆折叠模型)用于提取 AlphaFold2 结构中的空间特征(512 维 → 32 维);
- 使用多链结构用25 个 Gly 连接为一条伪序列,确保预训练模型能正常运行;
- 特征拼接后送入下一阶段建模。
步骤二:核心模块,PPI-Graphomer(界面建模利器)
借鉴微软提出的 Graphormer 思想,引入结构感知的图 Transformer 模块,具体包括:
| 编码方式 |
描述 |
| 氨基酸对类型编码 AAType(vᵢ,vⱼ) |
区分不同氨基酸组合,推测物理作用趋势 |
| 相互作用力编码 Interact(vᵢ,vⱼ) |
捕捉氢键、盐桥、π堆叠等相互作用数量 |
| 距离权重 Dij + 接口遮罩 |
仅关注跨链、7Å内的残基对,提高关注焦点准确性 |
这些信息被作为注意力偏置项加入到 Transformer 的 Attention 计算中,强化模型对关键界面信息的关注,最终获得接口表征。
步骤三:特征拼接 + 回归预测
使用“跳跃连接式”结构(skip-connection),将界面信息与全局序列结构信息拼接后输入 MLP 预测亲和力(ΔG),输出结果用于与真实值比较回归损失。
模型整体架构示意图如下:
数据集与训练配置如下:
主训练集:PDBbind(共 2376 条蛋白复合物,均转化为ΔG);
测试集:
Affinity Benchmark v1(Test set 1,75 个样本)
PDBbind 精炼子集(Test set 2,87 个样本)
预处理:
移除序列过长(>2000 残基)样本;
使用 BLAST 排除训练集中与测试集相似度>65%的样本,防止数据泄露;
模型参数:
Graphomer 层数:2 层;
Attention 头数:8;
训练轮次:20 epoch;
使用 A40 GPU,推理内存仅需 4GB。
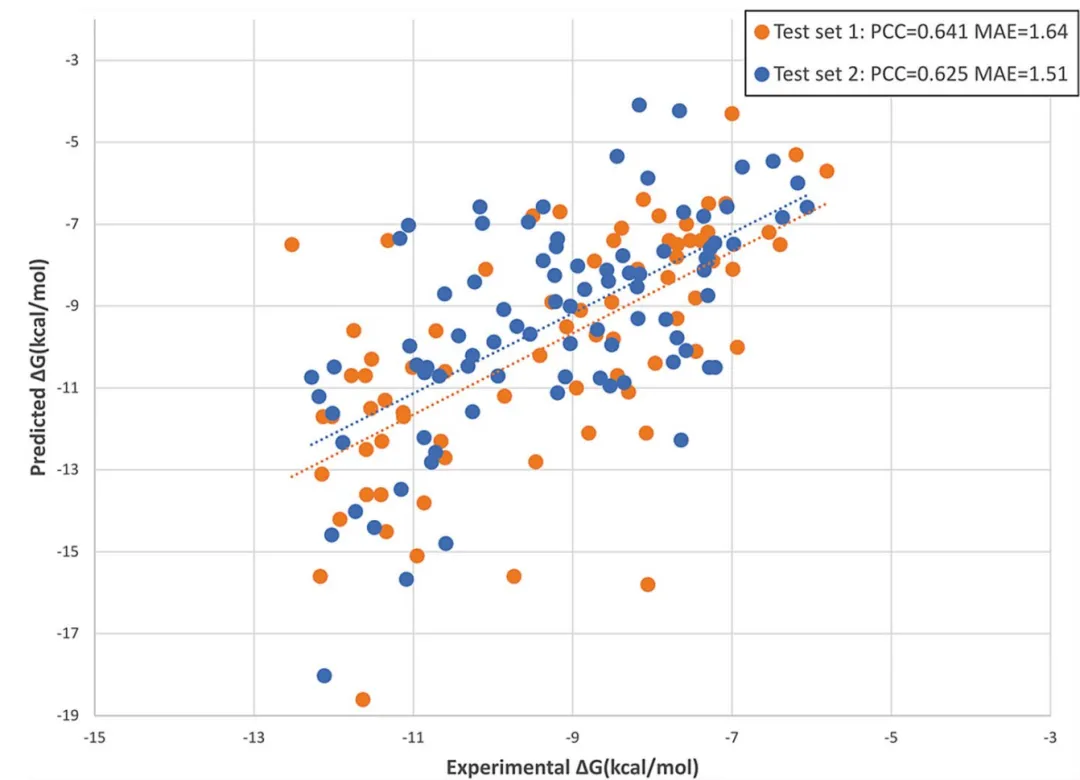
模型预测效果如下:
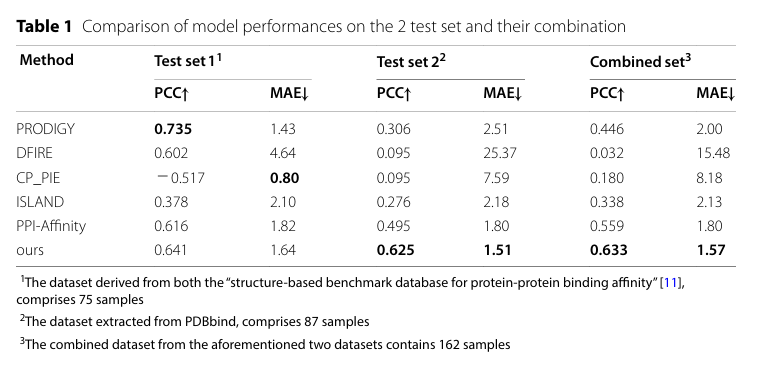
与其他方法的结果比较如下:
参数说明
Structure
蛋白复合物结构,格式支持 .pdb 或 .cif。蛋白长度需小于2000AA(超过时会略过)。
Structure TAR
蛋白复合物结构,支持多个复合物结构打包进行批量预测,格式支持 .tar、.tar.*z 或 .zip,最大支持1000个结构。
Output
亲和力预测的结果文件名,默认为PPI_pred.csv
结果说明
亲和力预测结果文件PPI_pred.csv,包含以下信息:
| 列名 |
说明 |
| Name |
结构名称 |
| Binding_Affinity (kcal/mol) |
预测的亲和力,为Gibbs自由能,单位为kcal/mol。负得越多,亲和力越强。注意:所提供的能量是复合物中所有链之间的亲和力总和。 |
参考文献
- Xie, J., Zhang, Y., Wang, Z. et al. PPI-Graphomer: enhanced protein-protein affinity prediction using pretrained and graph transformer models. BMC Bioinformatics 26, 116 (2025). DOI:10.1186/s12859-025-06123-2