Immunogenicity Prediction (WeADApt v4.2)
简介
WeADApt (Wecomput ADA prediction) 是唯信开发的基于多模融合深度学习架构的免疫原性预测系统(也被熟知为AlphaMHC)。
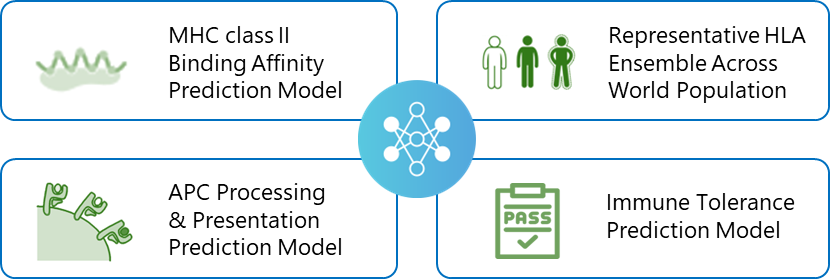
该方法采用全新的多模融合深度神经网络架构,整合了近10亿条与免疫原性相关的湿实验数据(包括亲和力数据、呈递数据、NGS数据、质谱数据等)进行训练,有机地将多个与免疫原性相关的模型融合,构成一个高效的免疫反应模拟系统,可准确地模拟蛋白、抗体、多肽、疫苗等生物药的免疫原性,并能鉴别潜在的免疫原性的T细胞表位(引起临床人体免疫应答的肽段),实现了从序列到临床免疫原性风险的端到端的预测,并通过了数百条来自FDA、EMA的临床真实免疫原性数据(包括单/多特异性抗体和重组蛋白等)的验证测试。
v4.2版本
该版本相比v4.1进一步提升了预测的特异性,且对不同风险水平的表位的区分度更高,结果对于去免疫原性改造更有指导性。
V4.2版本相对于上个版本v4.1主要有以下改进:
- 算法架构优化
- 测试集规模扩大1倍
- 分类能力F1提升:18%
- 特异性提升:26%
- 敏感性提升:4%
性能测试
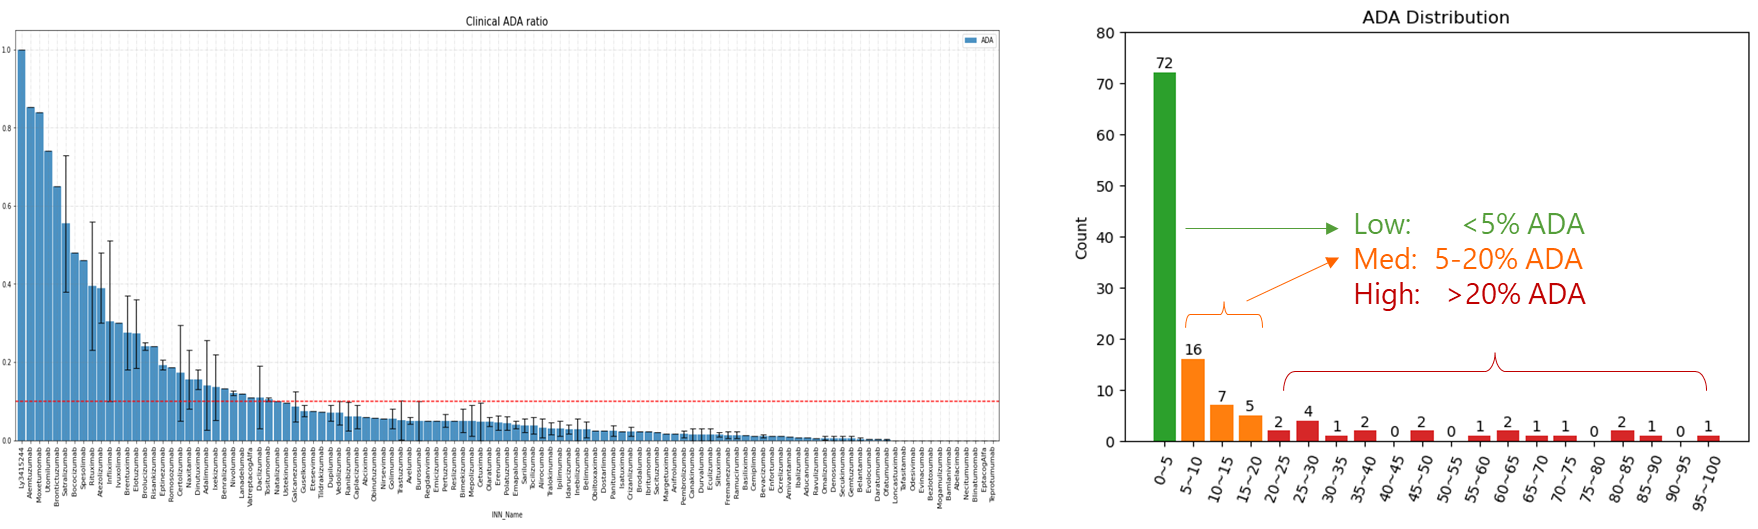
我们从FDA和EMA的临床试验中收集了200余个已知免疫原性的分子及其ADA的分布,计算模型预测值与真实ADA发生率的相关性,以测试预测性能。
在二分类测试中,将>20% ADA定义为高风险,20%以下定义为低风险。
单抗 mAb
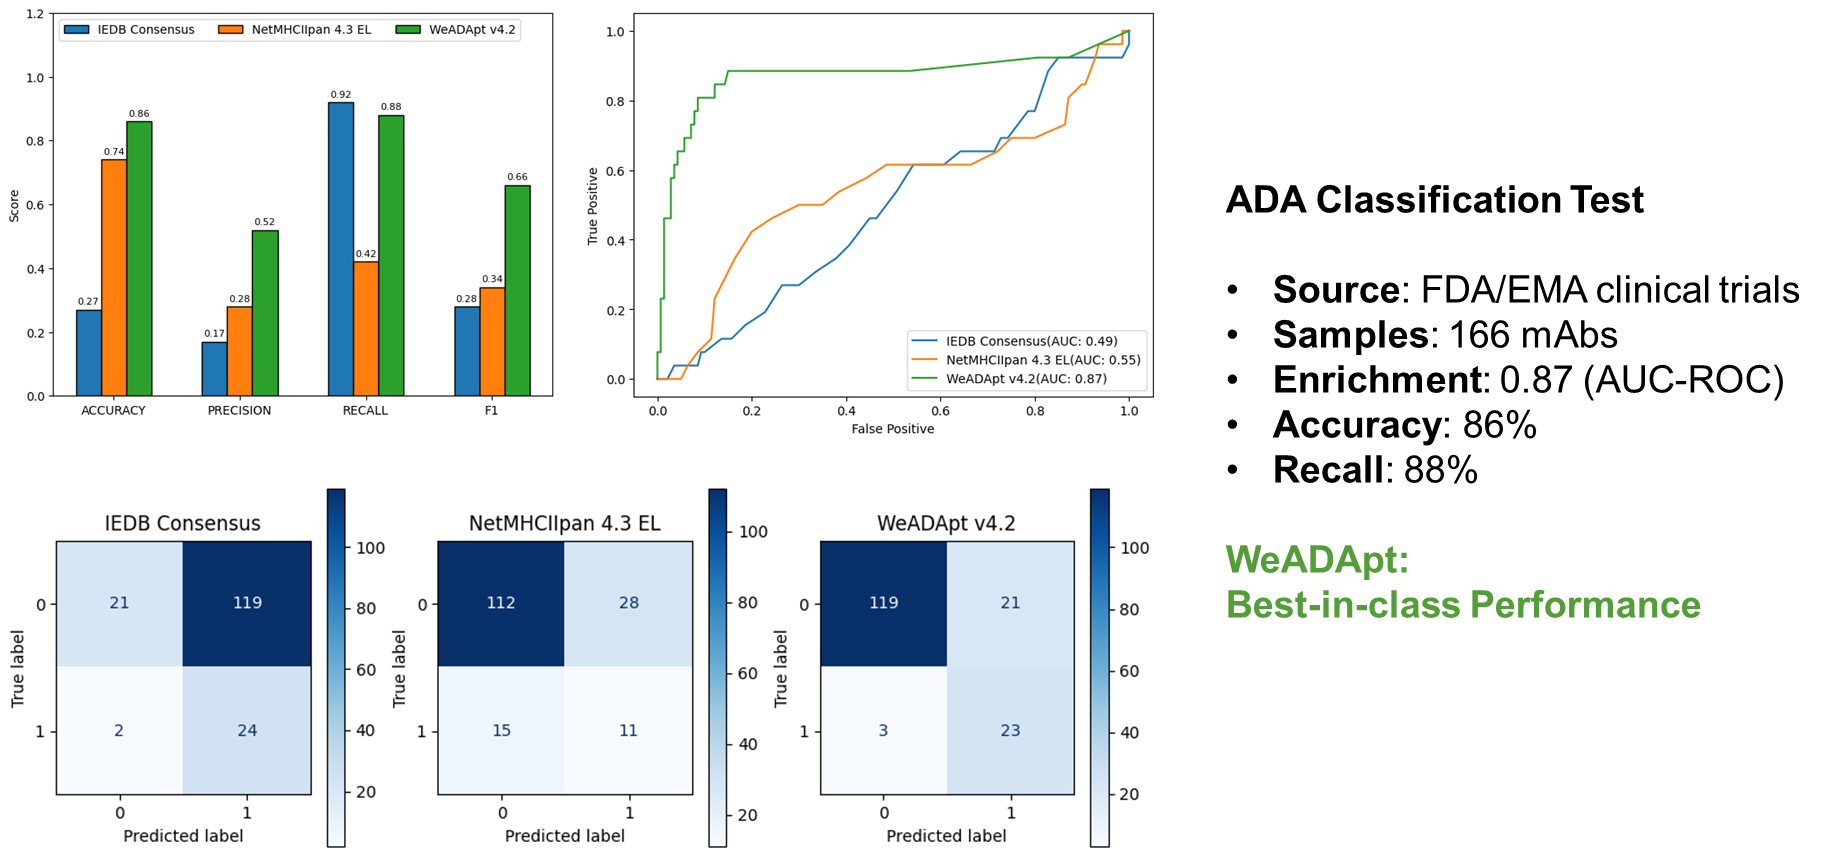
使用唯信收集整理的166个临床及上市单抗的ADA数据的测试结果如下图所示,0.2分作为单抗的高/低风险的阈值,WeADApt表现出了最好的分类能力,准确率为86%,召回率为88%,富集率(AUC)为0.87,超过了行业知名学术软件IEDB、NetMHCllpan等。
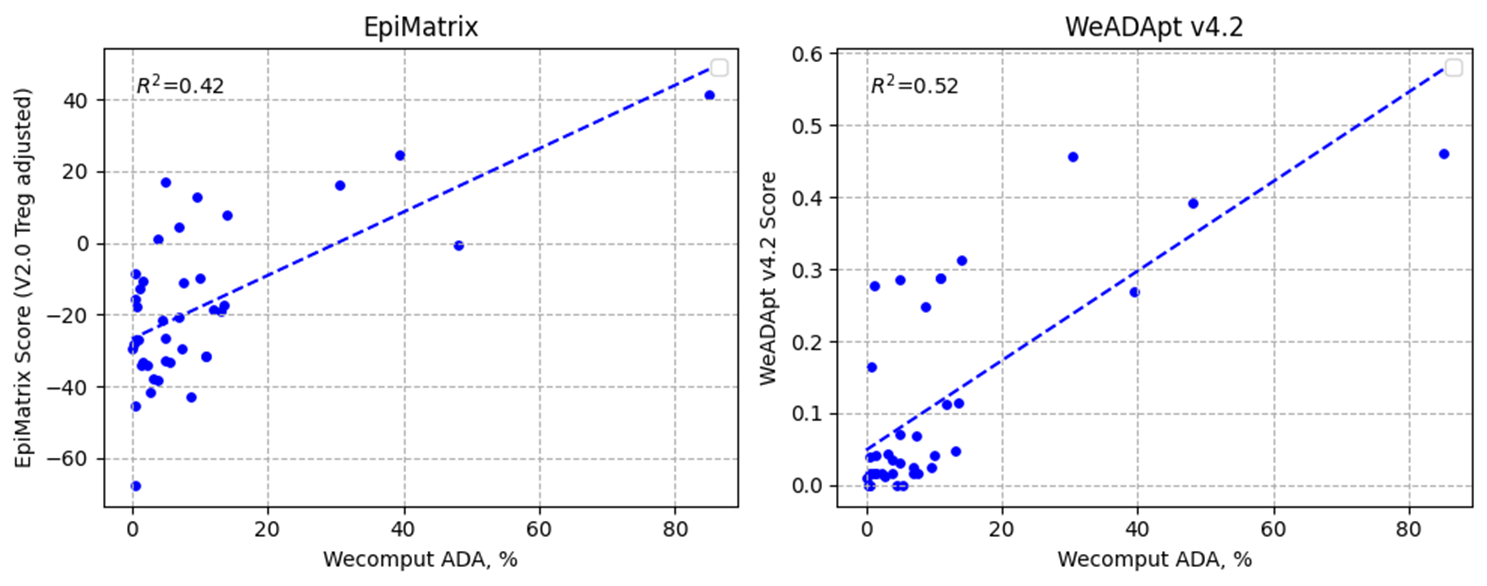
在EpiVax论文中公开的42个临床抗体分子的数据集上,WeADApt的预测结果与ADA的相关性超过了知名的商业软件EpiMatrix(R^2=0.52 vs R^2=0.42)。
双抗 BsAB
WeADApt被设计为兼容各类的分子形式,不论是对称还是非对称、是否有重复结构域的任意蛋白分子,仅需输入不重复的链即可(重复链全部输入也会自动处理)。
对比下图,WeADApt对于双抗的预测分数会相比实际ADA较单抗偏高,因此高风险的阈值建议比单抗相应提高至0.4附近。
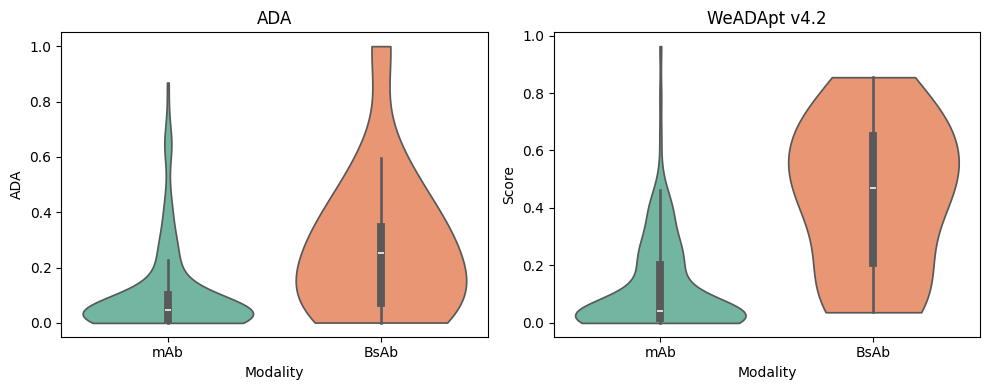
本系统仅从序列水平预测产生的影响,因此尤其适合同类靶点和相同MOA分子的相对比较和筛选。
实用建议
关于版本选择
新项目可以优先使用v4.2。对于已经使用过v4.1的项目,如果发现结果差异较大,可以参照已知临床分子的结果(比如阳性对照等),以一致性更高的版本为准。在可接受的情况下,尽量切换到v4.2。
关于风险阈值
实际项目中对于高风险阈值的定义,除了按照程序默认的单双抗0.2/0.4的标准之外,也可以以项目的阳性分子作为基准,因为不同靶点或MOA对于绝对值的影响还是蛮大的。
参数说明
动态计算量
≤ 5 条序列:5000 计算量 / 条
第 6–100 条序列:500 计算量 / 条
超过 100 条的部分:50 计算量 / 条
Fasta File
蛋白序列文件,FASTA 格式,必选参数。支持多条链以及多分子模式。对于多分子模式,序列名称规则为 分子名.链名,其中链名只支持单个字母,不支持数字或多个字母。
示例:
Molecule Score
蛋白级别的打分和风险评估结果文件。默认值为 MolScore.csv。
TCE Score
表位(TCE)明细数据输出文件。默认值为 TceScore.csv。
Export Details
是否导出明细数据,默认值为 no。开启后会影响运行效率;当序列数超过 20 时,即使设置为 yes 也不会输出明细。
Export Heatmap
是否导出可视化热图,默认值为 no。
Risk Threshold
自定义高低风险分界线,默认值为 0.2。小于该值标记为低风险(Low),大于或等于该值标记为高风险(High)。单抗建议设置为 0.2,双抗建议设置为 0.4。
Hide Low TCE
最终输出 TCE 明细数据时,自动过滤低于指定分数的 TCE 片段。默认值为 0。