
| 编号 | 447 | |
| 名称 | Protease (MMP) Cleavage Prediction | |
| 封面 |  | |
| 描述 | 预测肽段(长度不超过10个氨基酸)被18种基质金属蛋白酶(MMPs)切割的效率及基于指定目标切割谱生成相应的多肽底物。 | |
| 标签 |
| |
| 作者 | Carmen Martin-Alonso | |
| 发布时间 | 2025-03-26 16:03:42 | |
| 参考文献 | Carmen Martin-Alonso, Sarah Alamdari, Tahoura S. Samad, Kevin K. Yang, Sangeeta N. Bhatia, Ava P. Amini. Deep learning guided design of protease substrates. bioRxiv 2025.02.27.640681 | |
- 简介
- 参数说明
- Prediction
- Peptide Sequence
- Output
- Generation
- Number of Peptides
- Z-score of MMPs
- Temperature
- Output
- 结果说明
- Prediction
- Generation
- 参考文献
Protease (MMP) Cleavage Prediction
简介
该模块具有两方面的功能:
1,用于预测肽段(长度不超过10个氨基酸)被18种基质金属蛋白酶(MMPs)切割的效率。
2,基于指定的目标切割谱(如:仅被MMP13切割),生成相应的多肽底物。
模块基于CleaveNet模型实现,CleaveNet是一种基于深度学习的蛋白酶底物设计工具,通过整合预测与生成技术,实现了从“虚拟筛选”到“智能设计”的转变。
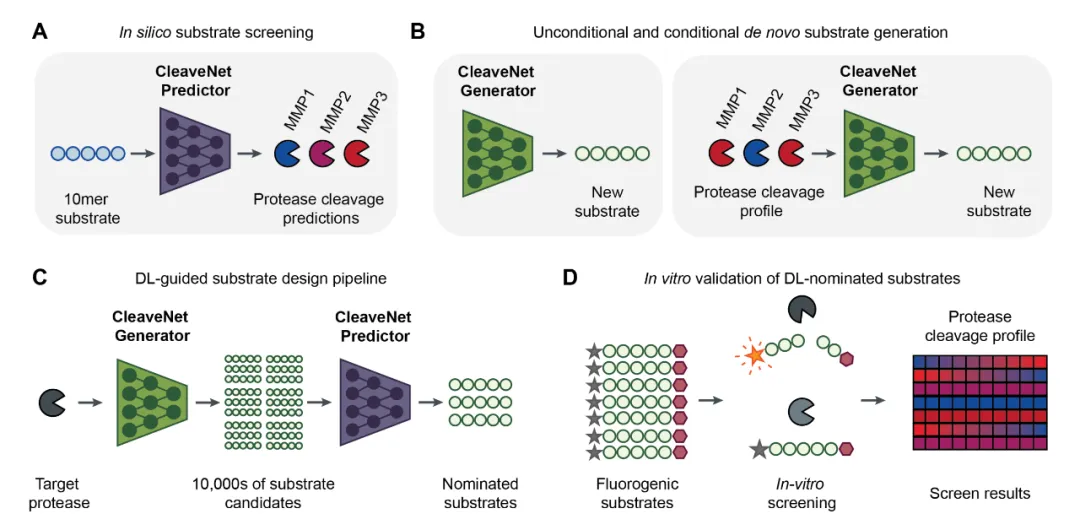
CleaveNet包含两个核心模块:
预测模块
- 基于Transformer架构,训练于大规模mRNA展示肽段库数据。
- 针对18种基质金属蛋白酶(MMPs),能够预测肽段被特定蛋白酶切割的效率,测试集Pearson相关系数达0.80,优于传统二分类模型。
- 模型不仅复现了已知的酶切基序,还发现了新的底物偏好,例如甲硫氨酸在P4位的作用,拓展了对蛋白酶特异性的理解。
生成模块
- 采用条件化生成技术,用户可通过条件标签指定目标切割谱(如“对MMP13高活性、对其他MMPs低活性”)。
- 通过注意力机制调整生成方向,生成的6-mer肽段新颖度达89%,突破了训练数据的局限性。
- 与传统虚拟筛选相比,生成效率提升约5.5倍,支持复杂设计需求,如“双蛋白酶逻辑门”底物。
这一端到端的设计流程显著提高了底物设计的效率和精准性,为蛋白酶研究提供了一种全新的计算驱动方法。
实验验证
为评估CleaveNet的实际应用能力,研究团队以MMP13(一种与癌症转移、伤口愈合和骨关节炎相关的胶原酶)为目标,设计并合成了95条肽段底物,并通过荧光共振能量转移(FRET)技术验证其切割效率。实验结果表明:
- 切割效率:所有CleaveNet设计的MMP13底物均能被有效切割,其中一条底物(DL73)的切割效率比训练集中最优底物高出39%(p<0.01)。
- 特异性:3条底物(如DL41)实现了对MMP13的绝对特异性,不被其他MMPs切割;5条底物(如DL48)同时表现出高活性和高选择性,填补了传统方法的空白。
- 机制洞察:分析生成序列后,发现了P2位亮氨酸偏好和P3’位天冬氨酸的作用,为MMP13的特异性机制提供了新的研究方向。
这些结果验证了CleaveNet在设计高效且特异性底物方面的能力,同时也展示了其揭示未知底物偏好的潜力。
参数说明
Prediction
Peptide Sequence
必填参数,多肽序列,txt或fasta格式,支持多条(txt格式时,每行放置一条多肽,最多支持1000条多肽)。注意:多肽长度不能超过10个残基,超过长度的多肽序列会自动被过滤掉。
txt格式实例如下:
LRVFL
FMPLNFTASG
LGPYAMTSRG
AARFKKFATE
Output
可选参数,预测得到的MMPs酶切概率结果文件名称,默认为“pred_cleavage.csv”。
Generation
Number of Peptides
可选参数,指定需要生成的多肽数量,默认为50。
Z-score of MMPs
可选参数,指定多肽生成的酶切条件,CSV文件格式。包含每种MMP酶的酶切概率Z-score值,值越大表示酶切的可能性越高,值可为负,一般阈值为2.5,大于该阈值时,表示极大可能被酶切。模型会根据设置的各种MMPs酶的酶切概率Z-score值进行多肽生成。注意:18种MMPs的Z-score数值都必须设定,不能缺少任意一种。
文件内容实例如下:
MMP1,MMP10,MMP11,MMP12,MMP13,MMP14,MMP15,MMP16,MMP17,MMP19,MMP2,MMP20,MMP24,MMP25,MMP3,MMP7,MMP8,MMP9
2.0,1.2,2.2,2.9,3.3,4.1,2.2,3.1,2.2,1.91,3.6,2.83,2.7,0.2,1.8,2.1,0.61,4.2
以上内容为一组条件,也支持多组条件同时输入,每行一组条件即可。每组条件都会生成指定数量的多肽。多组条件示例如下:
MMP1,MMP10,MMP11,MMP12,MMP13,MMP14,MMP15,MMP16,MMP17,MMP19,MMP2,MMP20,MMP24,MMP25,MMP3,MMP7,MMP8,MMP9
2.0,1.2,2.2,2.9,3.3,4.1,2.2,3.1,2.2,1.91,3.6,2.83,2.7,0.2,1.8,2.1,0.61,4.2
3.33,2.5,3.6,2.7,2.9,5.2,3.4,4.2,2.7,2.0,3.5,2.6,4.0,3.1,3.5,0.61,2.1,2.9
Temperature
可选参数,指定生成的温度条件,用于控制生成多肽序列的多样性,默认为1.0,越大表示多样性越高。如果希望多样性低一些,推荐0.7,如果希望多样性再高一些,推荐1.2~1.5。
Output
可选参数,指定序列输出文件名称,fasta或txt格式,默认为“gen_seqs.fasta”。
结果说明
Prediction
预测得到的MMPs酶切概率结果文件,默认为pred_cleavage.csv。包含如下内容:
| 字段名称 | 说明 |
|---|---|
| SEQ | 多肽序列 |
| MMP1,MMP2,MMP3,… | 各种MMPs蛋白酶对多肽酶切能力强弱的Z-score数值,数值越大表示酶切的可能性越高,目前的阈值为2.5,大于该阈值时,表示极大可能被酶切。 |
Generation
生成的序列文件,默认为“gen_seqs.fasta”。
参考文献
- Deep learning guided design of protease substrates. Carmen Martin-Alonso, Sarah Alamdari, Tahoura S. Samad, Kevin K. Yang, Sangeeta N. Bhatia, Ava P. Amini bioRxiv 2025.02.27.640681; DOI: 10.1101/2025.02.27.640681

