
| 编号 | 386 | |
| 名称 | Restrained Complex Structure Prediction | |
| 封面 |  | |
| 描述 | 基于ColabDock框架实现,ColabDock框架通过整合多种实验限制条件,显著提升了蛋白-蛋白对接预测的准确性。 | |
| 标签 |
| |
| 作者 | Shihao Feng | |
| 发布时间 | 2024-08-22 11:55:25 | |
| 参考文献 | Feng, S., Chen, Z., Zhang, C. et al. Integrated structure prediction of protein–protein docking with experimental restraints using ColabDock. Nat Mach Intell, 2024. | |
- 简介
- 参数说明
- Complex Structure
- Chains
- Fix Chains
- Threthold
- 1v1 Restrains
- MvN Restrains
- Rep Threthold
- Rep 1v1 Restrains
- 结果说明
- 参考文献
Restrained Complex Structure Prediction
简介
Restrained Complex Structure Prediction模块基于ColabDock框架实现,ColabDock框架通过整合多种实验限制条件,显著提升了蛋白-蛋白对接预测的准确性。其创新点包括:
- 无需大规模重新训练或微调:ColabDock框架通过梯度反向传播直接整合实验限制,避免了对深度学习模型进行大规模的重新训练或微调,提高了计算效率。
- 多源实验数据的整合能力:ColabDock能够处理不同形式和来源的实验数据,包括但不限于化学交联质谱(XL-MS)、核磁共振化学位移扰动(CSP)、共价标记(CL)和模拟的深度突变扫描(DMS)等,增强了模型的适用性和灵活性。
- 提升预测精度:通过在多个数据集上的评估,ColabDock展现出了超越现有方法的预测精度,尤其是在考虑实验限制条件时。不仅在具有模拟残基和表面约束的复杂结构预测中优于HADDOCK和ClusPro,而且在结合核磁共振化学位移扰动和共价标记辅助的情况下也表现出色。
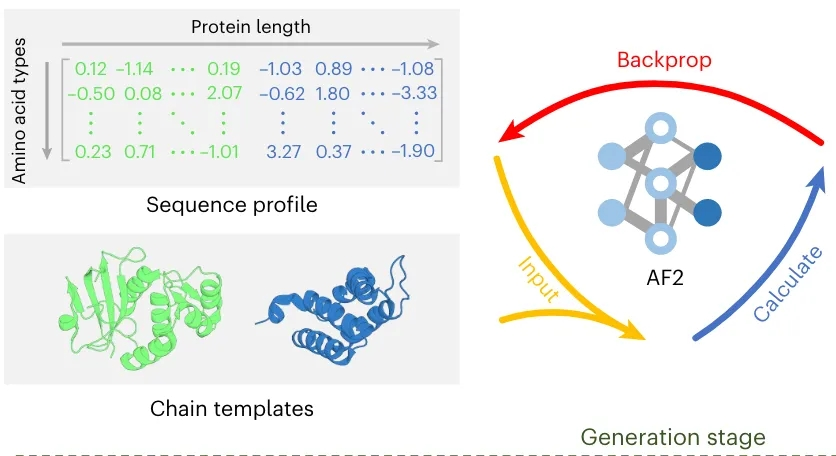
ColabDock框架的工作流程分为两个主要阶段:
- 生成阶段
- ColabDock生成阶段的目标是生成与提供的实验限制和模板相一致的蛋白质复合物结构。
- 该阶段使用梯度反向传播(Backprop)来优化输入序列配置文件的对数空间,从而引导结构预测模型(AF2)产生符合实验限制的复杂结构。
- 输入包括:蛋白质序列配置文件、每条蛋白链的模板,以及实验限制条件。
- 优化过程:模型通过调整序列配置文件来改变对接结构,同时保持预测的蛋白质序列与输入序列一致。
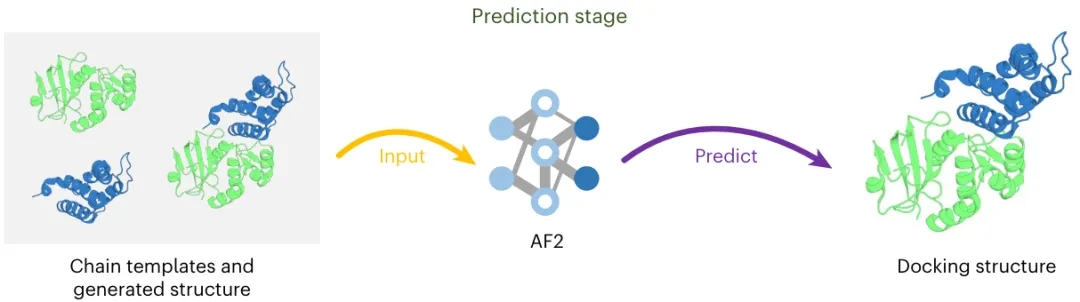
- 预测阶段
- 预测阶段使用生成的结构和每个链的模板进行最终的复杂结构预测。
- 这个阶段利用AlphaFold2(AF2)或其他深度学习模型来评估和细化复合物结构,提高预测的精确度。
- 预测阶段的输出是最终的蛋白质复合物结构预测,它考虑了实验限制并结合了深度学习模型的预测能力。
ColabDock主要关注两种类型的约束。第一种约束限制了残基对之间的距离低于某一阈值,属于残基-残基层面的约束(称为1v1约束)。这类约束包括源自交联质谱(XL-MS)的约束。第二种约束定义了在蛋白质表面上可能接触的两组残基之间的约束,但具体的接触信息未知。此类约束属于界面层面的约束(称为MvN约束),典型示例包括多种NMR实验和共价标记(CL)。
ColabDock在模拟约束条件下的性能验证情况如下图所示:
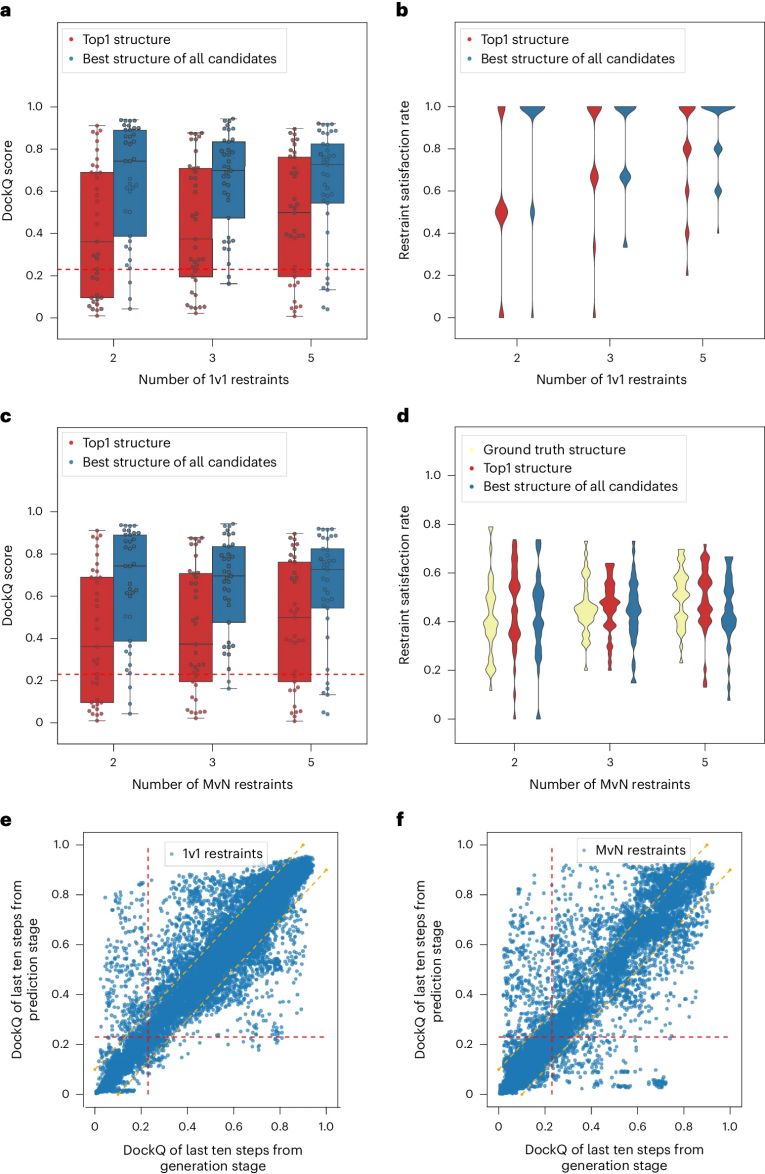
如图a所示,在仅提供两个1v1约束的情况下,81.08%的蛋白质复合物的最大DockQ值超过了0.23,尤其考虑到从这些约束中获取的结构信息相对有限。当提供三到五个约束时,成功率接近100%。如图b所示,对于含有两、三和五对约束的蛋白质复合物,其约束满足率分别为0.55、0.77和0.80。这些结果表明,ColabDock能够高效利用提供的约束来获得高质量的复合物结构。
评估ColabDock在MvN约束下的性能时,先基于上述1v1样本生成了MvN样本。这些样本的挑战性更大,因为MvN约束的模糊性使得多个1v1约束组合可能满足同一组MvN约束。如图c所示,111个样本中有100个预测结构的最大DockQ值超过了0.23。其中,75个样本的top1结构的DockQ值超过0.23。随着约束数量的增加,ColabDock的准确性也相应提高,top1结构的成功率从两个约束时的62.16%上升到三个和五个约束时的70.27%。在预测结构中,约束满足率与实验结构中的比例相似(图d)。这些结果表明,ColabDock同样能够高效利用模糊的约束条件来改善结构预测。
为了评估ColabDock中预测阶段的必要性,在上述1v1和MvN约束实验中,收集了最后十个优化步骤中的结构,大多数优化过程已经收敛。在生成阶段和预测阶段的DockQ值差异较大的情况下(这里定义为大于0.1),预测阶段在69.9%的1v1约束复合物中表现更好(图e),在MvN约束复合物中这一比例为68.8%(图f)。这些结果表明,AF2的能量景观可以帮助优化生成阶段的构象并提高预测的准确性。
ColabDock与传统限制性对接方法比较如下图所示:

基于37个蛋白质复合物的独立基准集。与HADDOCK和ClusPro进行了比较。对于基准集中的每个复合物,采样两、三和五个1v1约束来指导对接,最终生成了111个样本。ColabDock在大多数样本中优于HADDOCK和ClusPro(图a)。ColabDock的平均DockQ值为0.477,而HADDOCK和ClusPro的DockQ值分别为0.287和0.191。无论1v1约束的数量多少,ColabDock在三种方法中均表现最佳(图b)。这些结果表明,ColabDock在稀疏约束条件下有生成可靠结构的潜力,这与验证集的观察结果一致。
为了进一步评估ColabDock在界面级别约束下的表现,作为验证数据集,将上述描述的1v1约束转换为MvN约束。由于ClusPro在111个样本中有7个无法给出预测,将其排除,并对剩余的104个样本进行比较。与1v1约束下的表现相比,由于MvN约束的模糊性,ColabDock、HADDOCK和ClusPro在MvN约束下的表现有所下降,但ColabDock仍然优于其他两种方法(图c)。实验再次表明,无论MvN约束的数量多少,ColabDock在DockQ上均表现最佳(图d)。
实验衍生的约束中常常包含相距较远的残基,作者将其称为“松散约束”。为了测试模型在相关任务中的表现,有意在距离范围为8Å到20Å之间加入了松散约束。对于基准集中的每个复合物,松散约束的数量从1到5不等,而总约束数量固定为5个,共生成了185个样本。排除了9个ClusPro无法处理的样本,并对剩余的176个样本进行了三种方法的比较。结果显示,ColabDock表现最佳,平均DockQ值为0.344,平均α碳原子r.m.s.d.(Cα-r.m.s.d.)为6.55Å(图e)。这些结果表明,ColabDock对约束的质量依赖较低。当与高质量约束结合时,ColabDock能够预测出比其他两种方法更为精确的结构。
抗原抗体复合物预测
抗体-抗原复合物建模一直是一个长期存在的挑战,因为互补决定区(CDRs)的灵活性和缺乏共同进化信号。深度突变扫描(DMS)是一种常用技术,用于确定可能参与抗体-抗原结合的残基。基于一个包含45个复合物的抗体-抗原基准集,通过采样界面上的残基来模拟DMS衍生的约束。预测效果及与传统方法的比较情况如下图所示:
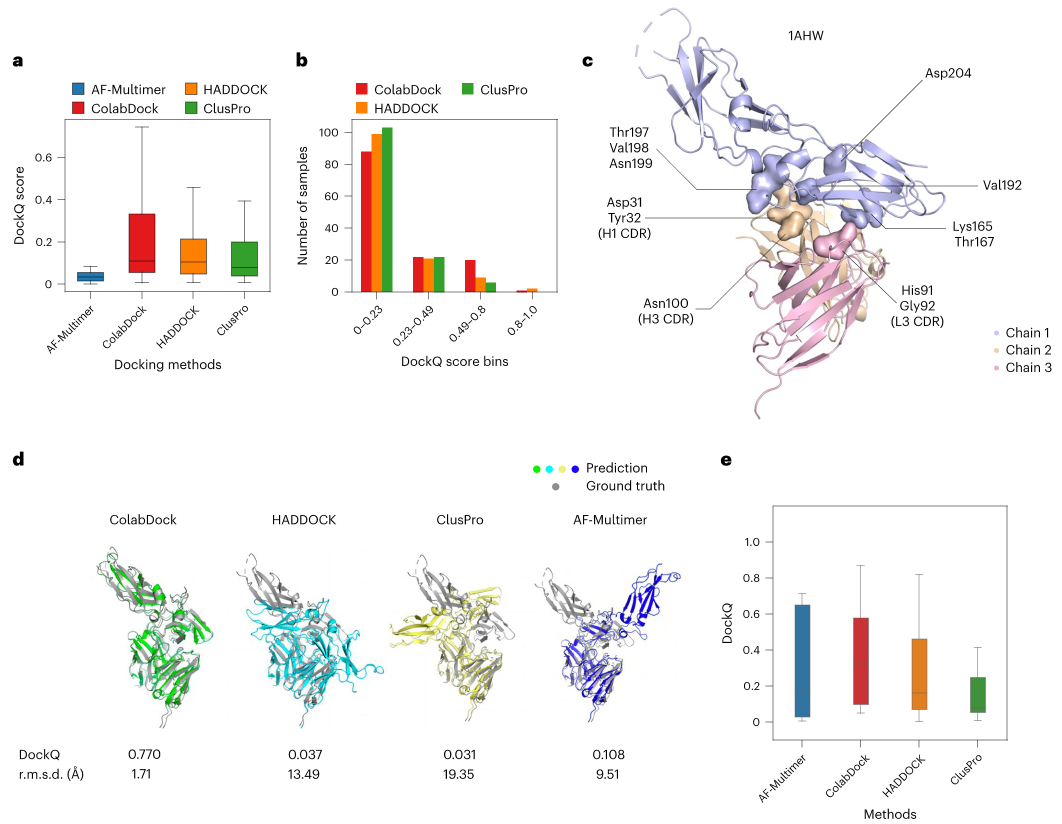
图a所示,ColabDock优于HADDOCK和ClusPro,其平均DockQ值为0.223,平均r.m.s.d.为9.57Å。对于DockQ值大于0.49的样本数量,ColabDock也超过了HADDOCK和ClusPro(图b)。
以1AHW为例:1AHW是一个人类组织因子-抗体(5G9)复合物,参与了血液凝固蛋白酶级联过程。如图c所示,随机从抗体中采样了五个界面残基(轻链的His91和Gly92,重链的Asp31、Tyr32和Asn100),以及从抗原中采样了七个界面残基(Lys165、Thr167、Val192、Thr197、Val198、Asn199和Asp204)。这些在抗体中采样的残基主要分布在L1 CDR、H1 CDR和H3 CDR区域。图d展示了AF-Multimer的预测结构以及三种对接方法的结构。如图e所示,ColabDock捕捉到了大多数界面上的天然接触,其DockQ值为0.770,r.m.s.d.为1.17Å,而其他方法的预测结构与天然构象有较大差异。这一案例研究表明,ColabDock在构象探索和构象排序方面都优于其他两种方法。
参数说明
Complex Structure
初始蛋白复合物结构文件,PDB格式
注:该结构由多条链组成,链与链之间的相对位置可任意放置,无要求。由于显存大小限制,当前最大支持的最终复合物尺寸大小不超过800个残基。
Chains
复合物中提取多条链,用于组成最终的复合物结构,链名之间用逗号分隔,如:A,H,L
Fix Chains
提取的多条链中指定相对位置固定的每对链,支持定义多对,链名之间用逗号分隔,每行一对,示例如下:
H,L
A,H
表示链H与L之间的相对位置固定,链A与H之间的相对位置固定。
Threthold
实验限制的距离阈值,表示设置限制的残基间的距离需小于该阈值。默认为8.0 Å,值范围为2.0 Å - 22.0 Å,建议采用默认值。
1v1 Restrains
单个残基之间的限制条件,限制单个残基之间的距离在上述定义的阈值参数内,残基之间用逗号(,)分隔,支持定义多个条件(每行定义一个),示例如下:
A20,H50
A78,L98
该参数表示设置的限制条件有2个:
- A链的第20位残基和H链的第50位残基之间的距离要小于阈值;
- A链的第78位残基和L链的第98位残基之间的距离要小于阈值。
注意:残基编号为位置编号,即每条链按顺序从1开始进行编号,以下编号规则一致。
MvN Restrains
单个残基与残基组合之间的限制条件,限制单个残基与多个残基集合中至少一个残基之间的距离在上述定义的阈值参数内,单个残基与残基组合之间用逗号(,)分隔,残基组合内部用分号(;)分隔,可支持定义多个条件(每行定义一个),示例如下:
A10,H60-70;H78;L90
A78,H60-70;L56;L69
A120,L30-L36;H68;H72
2
该参数表示设置的限制条件有3个,分别是:
- A链第10位残基与残基组合(H链第60至70位、H链第78位及L链第90位残基)中的至少一个残基之间的距离小于阈值;
- A链第78位残基与残基组合(H链第60至70位、L链第56位及L链第69位残基)中的至少一个残基之间的距离小于阈值;
- A链第120位残基与残基组合(L链第30至36位、H链第68位及H链第72位残基)中的至少一个残基之间的距离小于阈值;
- 最后一行的数值2,表示上述3个条件中,满足任意2个条件即可,如限制条件只有1个时,该数值可以省略。
Rep Threthold
限制残基间排斥的距离阈值,表示设定的排斥残基间的距离需大于该阈值。默认为8.0 Å,值范围为2.0 Å - 22.0 Å,建议采用默认值。
Rep 1v1 Restrains
单个残基间的排斥限制条件,限制单个残基之间的距离需大于上述定义的排斥阈值,残基之间用逗号(,)分隔,可支持定义多个条件(每行定义一个),示例如下:
15,98
60,205
该参数表示设置的排斥限制条件有2个:
- 编号顺序为第20和第50的残基之间的距离要大于排斥阈值;
- 编号第78和第198的残基之间的距离要大于排斥阈值。
结果说明
输出1st_best.pdb结果文件,为预测得到的最优复合物结构文件。
输出pdbs.tar.gz文件,为预测得到的前5个最优复合物结构文件压缩包。
输出summary.txt文件,包含以下信息:
| 列名 | 说明 |
|---|---|
| pdb | 复合物结构文件名 |
| iptm | 复合物结构的质量好坏评价指标,0-1之间,越接近1表示预测结构的质量越好 |
| # of satisfied restraints | 限制条件的数量,以及预测的复合物结构能满足的条件数量,如:2/2表示有2个限制条件,预测得到的复合物结构都能满足;1/2表示有2个限制条件,但复合物结构只满足了其中1个 |
备注:
可能存在以下个别情况,属正常现象
- 1st_best.pdb的iptm打分并不是5个结构里最优的;
- 结构中有个别残基间的肽键发生断裂;
有待结构预测模型的进一步优化。

