
| 编号 | 242 | |
| 名称 | Antibody Sequence Prediction (AbLang2) | |
| 封面 |  | |
| 描述 | 模块基于Ablang2模型实现,该模型是抗体专用语言模型,为AbLang的升级版,旨在解决抗体序列中的种系偏差(germline bias)问题,从而更有效地支持抗体设计与优化。 | |
| 标签 |
| |
| 作者 | AbLang | |
| 发布时间 | 2023-01-16 00:00:00 | |
| 参考文献 | Olsen TH, Moal IH, Deane CM. AbLang: an antibody language model for completing antibody sequences. Bioinform Adv. 2022 Jun 17;2(1):vbac046 | |
- 简介
- 输入参数
- Fasta File
- Position
- Output Fasta
- Output Prob
- 结果说明
- 参考文献
Antibody Sequence Prediction (AbLang2)
简介
进行抗体序列突变优化,同时给出序列每个位置20种残基的出现概率值(基于原序列预测)。模块基于Ablang2模型实现,该模型是抗体专用语言模型,为AbLang的升级版,旨在解决抗体序列中的种系偏差(germline bias)问题,从而更有效地支持抗体设计与优化。
抗体多样性主要来源于V(D)J重组、CDR区域的突变以及少量非CDR区域的突变。然而,天然抗体序列中仍有很大部分与种系基因(germline)保持一致,这导致传统语言模型在预训练过程中倾向于“记住”种系序列,而忽视了那些远离种系、但对结合能力至关重要的突变。AbLang2模型的核心目标就是缓解这种种系偏差,提升模型对非种系残基的预测能力,从而更有效地指导抗体工程中的关键突变设计。
AbLang2基于Transformer架构,延续了前代模型AbLang的双组件设计。使用OAS数据库中的非配对(仅重链或轻链)和配对(重链+轻链)抗体序列数据进行训练和微调,提升模型对完整抗体结构的建模能力。
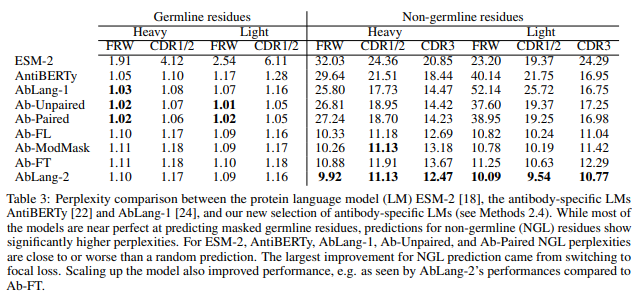
模型预测抗体序列困惑度(perplexity,数值越小表示序列质量越高)的对比,Ablang2效果最佳:
输入参数
Fasta File
指定需要优化残基的抗体Fv区序列文件,FASTA格式。如果同时有重链Fv(VH)、轻链Fv(VL)序列,通过英文冒号:将序列进行分隔即可,不分先后。如下所示:
>seq1
EVQLLESGGEVKKPGASVKVSCRASGYTFRNYGLTWVRQAPGQGLEWMGWISAYNGNTNYAQKFQGRVTLTTDTSTSTAYMELRSLRSDDTAVYFCARDVPGHGAAFMDVWGTGTTVTVSS
>seq2
QVQLQQSGGELAKPGASVKVSCKASGYTFSSFWMHWVRQAPGQGLEWIGYINPRSGYTEYNEIFRDKATMTTDTSTSTAYMELSSLRSEDTAVYYCASFLGRGAMDYWGQGTTVTVSS:EIVLTQSPGTLSLSPGERATLSCRASQSVSSSFFAWYQQKPGQAPRLLIYGASSRATGIPDRLSGSGSGTDFTLTITRLEPEDFAVYYCQQYDSSAITFGQGTRLEIK
重、轻链同时存在时,后续突变优化过程中,模型会同时考虑重、轻链,符合实际情况。
Position
指定需要突变优化的残基。使用残基位置编号(从1开始),多个残基用逗号分隔,指定残基范围用横杠符号。如:3,10,24-30表示序列中的第3、第10与第24至30号残基,进行突变优化。
在序列中同时存在重、轻链时,需要在残基序号前加上重(H)、轻链(L)标签,如:H5,H8-10,L3表示序列中,重链的第5、第8-10,轻链的第3号残基进行突变优化。
注意:这里定义的待优化残基,会同时应用到Fasta文件中的每条序列(如有不匹配的残基位置,会被自动过滤掉)。
Output Fasta
输出优化序列的文件名,Fasta格式,默认为restored.fasta,每条序列仅会产生一条优化的序列。
Output Prob
输出残基概率文件名,CSV格式,默认为restore_probs.csv,输出原序列对应的Positions位置20种残基出现的概率值,以及对应位置优化后的残基。
结果说明
优化后的序列文件restored.fasta
残基概率文件restore_probs.csv,包含信息如下:
| 字段名称 | 说明 |
|---|---|
| Name | 原序列名称 |
| Chain | 链类型,H或L |
| WT | 序列中的初始残基 |
| POS | AA的位置系引(从1开始) |
| Restored | 序列优化后,该位置的残基 |
| Consensus | 该位置出现概率最大的残基 |
| L,A,G,V… | 该位置每种残基出现的概率 |
注意:Restored的残基并不一定都是Consensus残基,因为概率计算是基于原序列整体计算的,而序列优化是对所有待优化残基进行掩码后(使用*代替原残基),计算可能的最优残基,出现概率会有差异。
参考文献
- Olsen TH, Moal IH, Deane CM. AbLang: an antibody language model for completing antibody sequences. Bioinform Adv. 2022 Jun 17;2(1):vbac046.DOI:10.1101/2022.01.20.477061
- Addressing the antibody germline bias and its effect on language models for improved antibody design. Tobias H. Olsen, Iain H. Moal, Charlotte M. Deane. bioRxiv 2024.02.02.578678.DOI:10.1101/2024.02.02.578678

