Immunogenicity Prediction (AlphaMHC v2.0)
简介
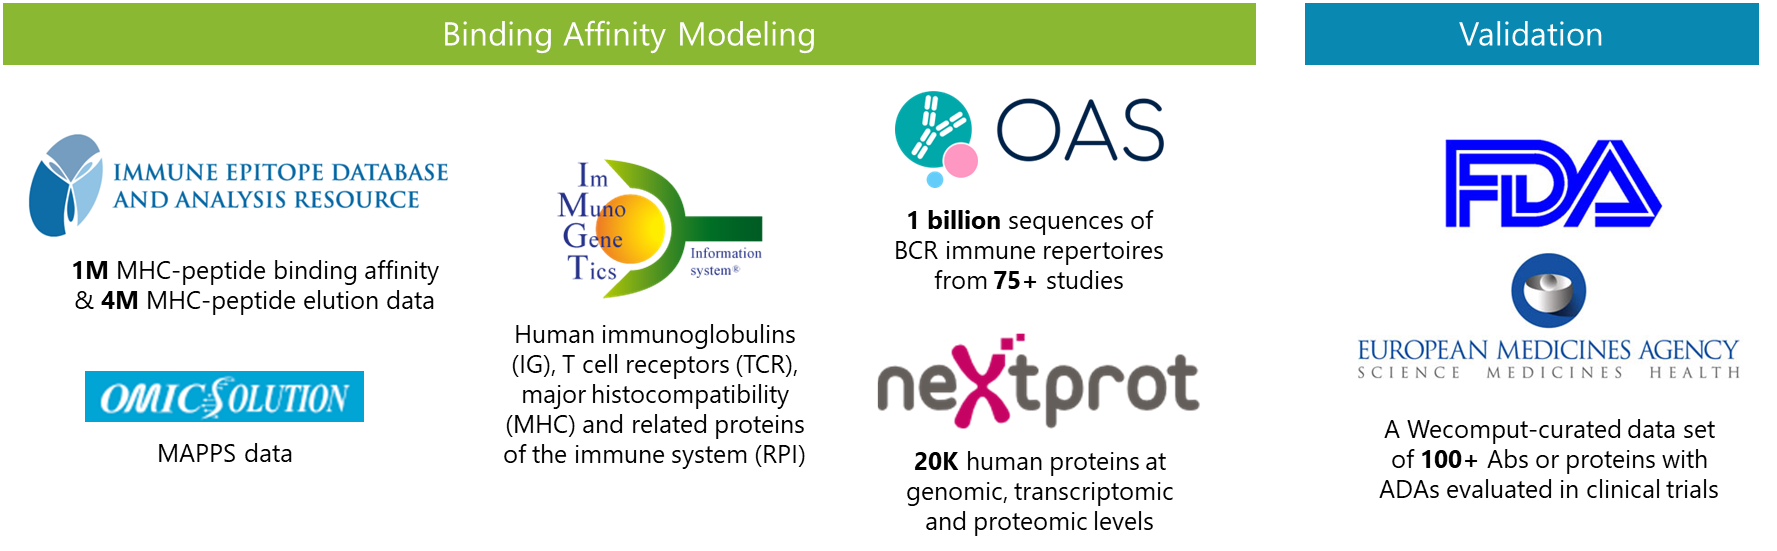
AlphaMHC是唯信计算为解决现有预测方法的已知问题而开发的下一代免疫原性预测算法,采用流行的NLP自然语言处理技术,全新的多模融合深度神经网络架构,整合了近10亿条公开及私有的与免疫原性相关的湿实验数据(包括亲和力数据、NGS数据、质谱数据等)进行训练,成功实现了从序列到临床免疫原性风险的端到端的预测,并通过上百条来自FDA、EMA的临床真实免疫原性数据(包括单/多特异性抗体和重组蛋白等)进行验证,AlphaMHC能够准确区分免疫原性的高低,ROC-AUC达0.87,准确性超过80%(部分测试集高达91%),表现出比现有方法显著更优的预测性能,是已知唯一一个可以得到临床数据验证的算法。
算法特点:
- 显着扩展的训练集空间。除了公开可用的数据集外,我们还从文献、专利和湿实验室合作者那里收集了更多数据。除了最常用的亲和力数据外,还考虑了更多的数据类型,例如T细胞激活数据、蛋白质组学数据、抗体测序数据等,它们贡献了超过10亿个数据条目/点。
- 与仅预测MHC肽结合亲和力的大多数其他算法不同,AlphaMHC 预测临床水平的最终免疫原性,同时考虑除肽结合之外的其他重要影响因素,例如免疫呈递/耐受性、HLA等位基因频率等。
- 针对上千个MHC-II型等位基因训练深度神经网络模型。在并行计算的支持下,所有支持的 MHC 等位基因都可以以高通量的方式同时计算。
- 基于独家收集的高质量临床ADA数据集进行验证和优化
参数说明
Fasta File
蛋白序列文件,FASTA格式。支持多条链以及多分子模式。
请注意按下面的规则来书写序列名,因为目前免疫原性风险的评分是以整个分子为单位的,链名会影响到程序区分同个分子的多条链,并影响对于分子总的风险评级(risk per molecule),但不影响对链的TCE的识别。
对于多条链的分子,序列名称应写为:分子名.链名,".“之前是分子名,”.“之后是链名,同个分子的不同链,只要”."之前的分子名保持一致就可以了,链名随意,顺序不限。
例如,下面mol1是常见的单抗,mol2是多抗:
HLA Allotypes
预测HLA等位基因型。
rep:32个代表性等位基因型,适用于一般人群。
all:用于训练的所有非冗余人类等位基因型(1166个)。
一般推荐使用默认的"rep",因为免疫原性的风险评分(risk)是基于rep的代表性HLA来确定的。
Binding Affinity Profile
导出每个 HLA 等位基因的结合亲和力曲线图,展示了与每条蛋白质链的 N 端到 C 端的所有15肽的结合亲和力。注意:即使“HLA Allotypes”选项设置为全部,也只会绘制代表性 HLA的曲线。
结果说明
输出结果包括:
| 输出文件名称 |
说明 |
| score_immunogenicity_risk.csv |
该结果展示了预测的每个分子的免疫原性风险(自动将同个分子的多条链的预测的潜在T细胞表位的结果进行汇总后综合评估所得)。 |
| detail_tce_of_chains.csv |
该结果评估可以进行定向改造的HLA呈递表位,以降低免疫原性。 |
| BAProfile_of_mol.chain.png |
不同HLA亚型与每条链的不同位置的亲和力的分布情况,更精细的展示了不同HLA的亲和力的差异。 从左到右的分布图表示从其中一条蛋白质链的N末端移动到C末端的15聚肽窗口的结合亲和力。 即使“HLA同种异型”选项设置为“全部”,也只会包括代表性的HLA等位基因。 |
| Heatmap_of_mol.chain.png |
每个肽与代表性HLA之间结合亲和力的热图。Z-score是pAffinity,值越大(浅色)意味着预测结合越强。 |
其中score_immunogenicity_risk.csv包括信息如下:
| 字段名称 |
说明 |
| Protein_Id |
蛋白序列名称 |
| Risk |
预测的分子整体风险评估,高风险的分子为high,否则为low。 |
| Score |
表位总长度,是整体风险评估的重要依据。 |
| TCE_Sequences |
表位序列 |
其中detail_tce_of_chains.csv包括信息如下:
| 字段名称 |
说明 |
| Sequences |
蛋白序列名称 |
| TCE |
每条链的相对的高风险的T细胞表位 |
| Alleles_Number |
递呈的HLA亚型数 |
| Alleles |
递呈的HLA亚型 |
| Min_Affinity |
亲和力最小值 |
| Median_Affinity |
亲和力中位数 |
| Max_Affinity |
亲和力最大值 |